SKU主图生成-AI图像功能

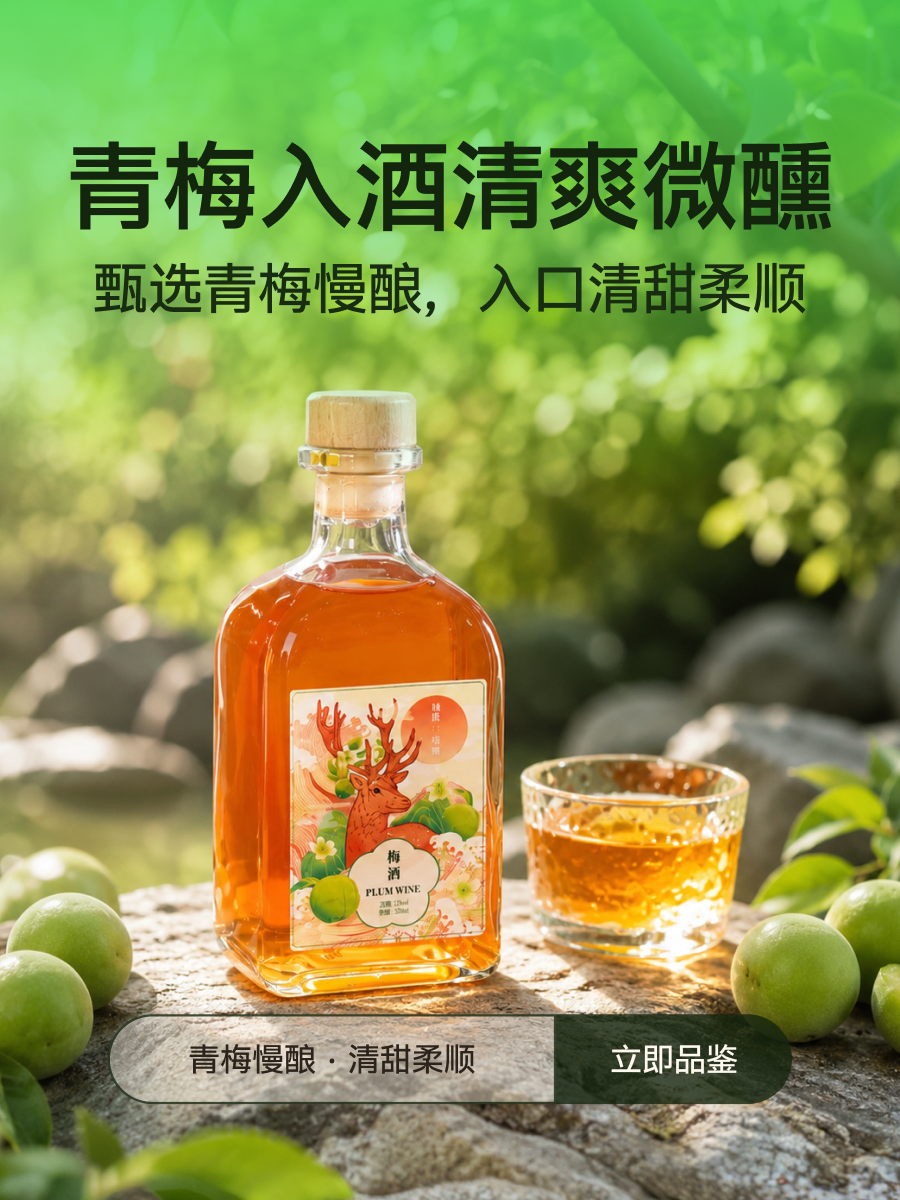
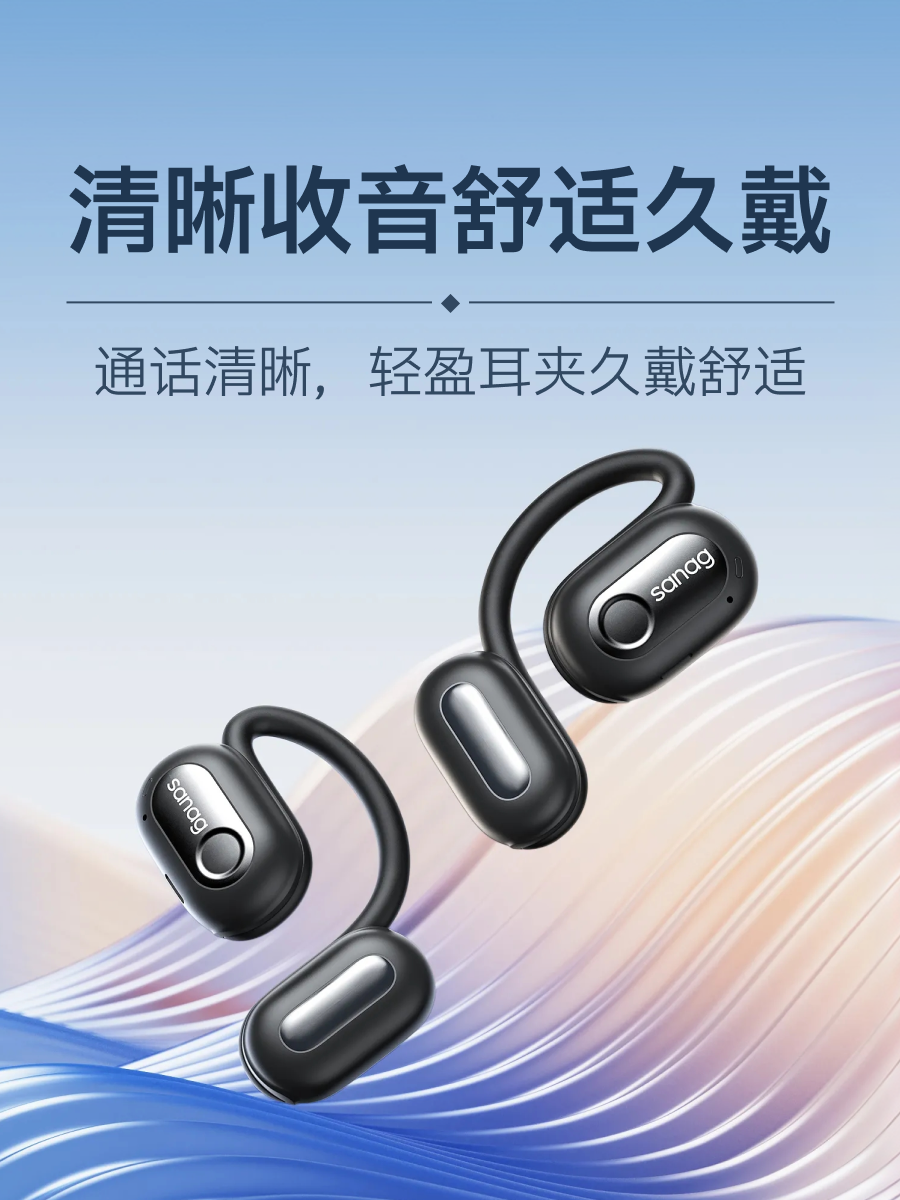
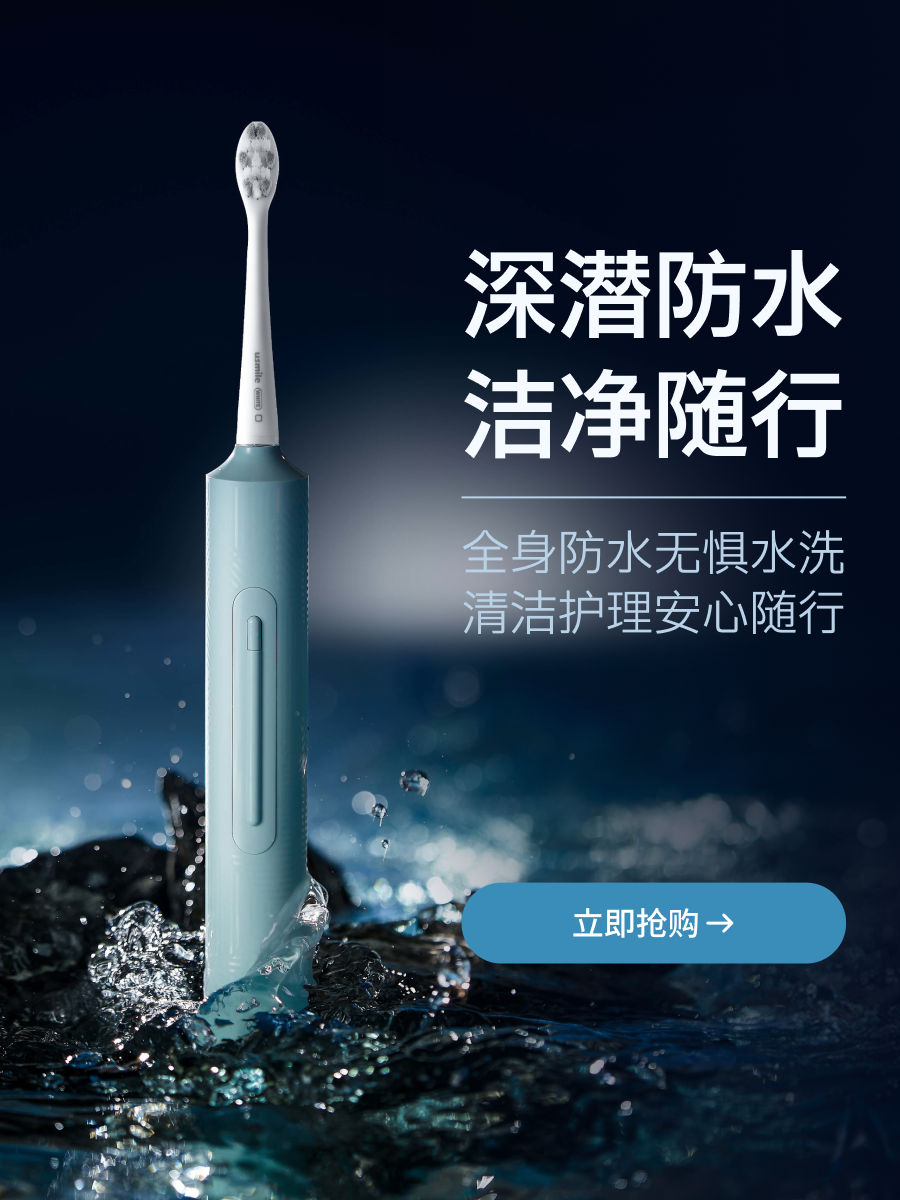
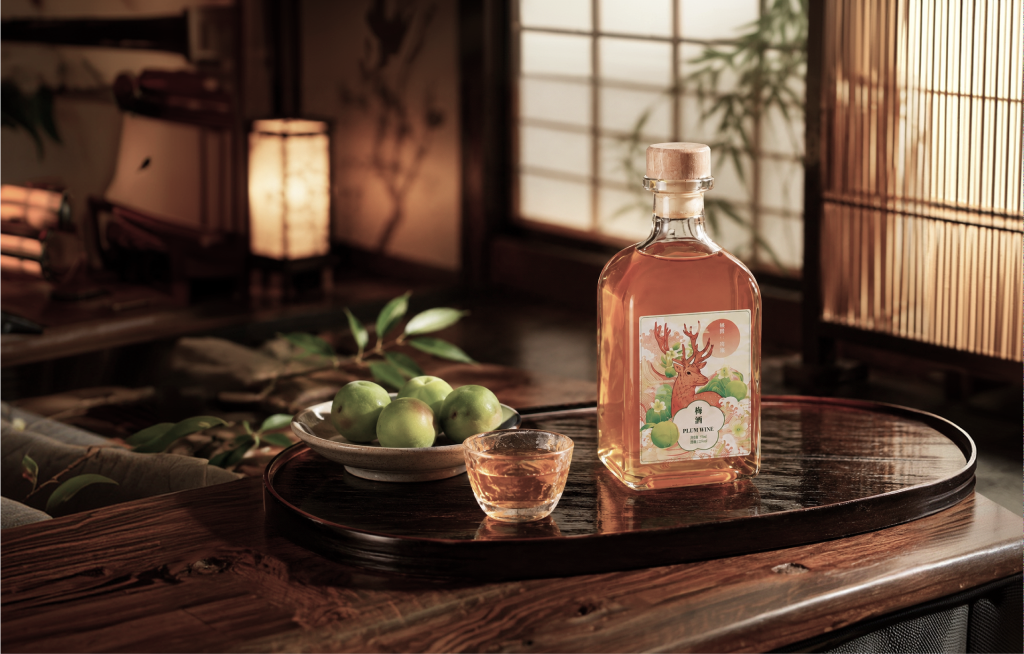
商品图是京东平台的核心视觉入口,直接影响点击和转化。传统模式下多个商品共用同一套背景模板,同质化严重且无法呈现产品卖点。项目用 AI 将商品主图从"多品共用一套背景"推进到"单 SKU 多场景生成",系统性解决这个问题。


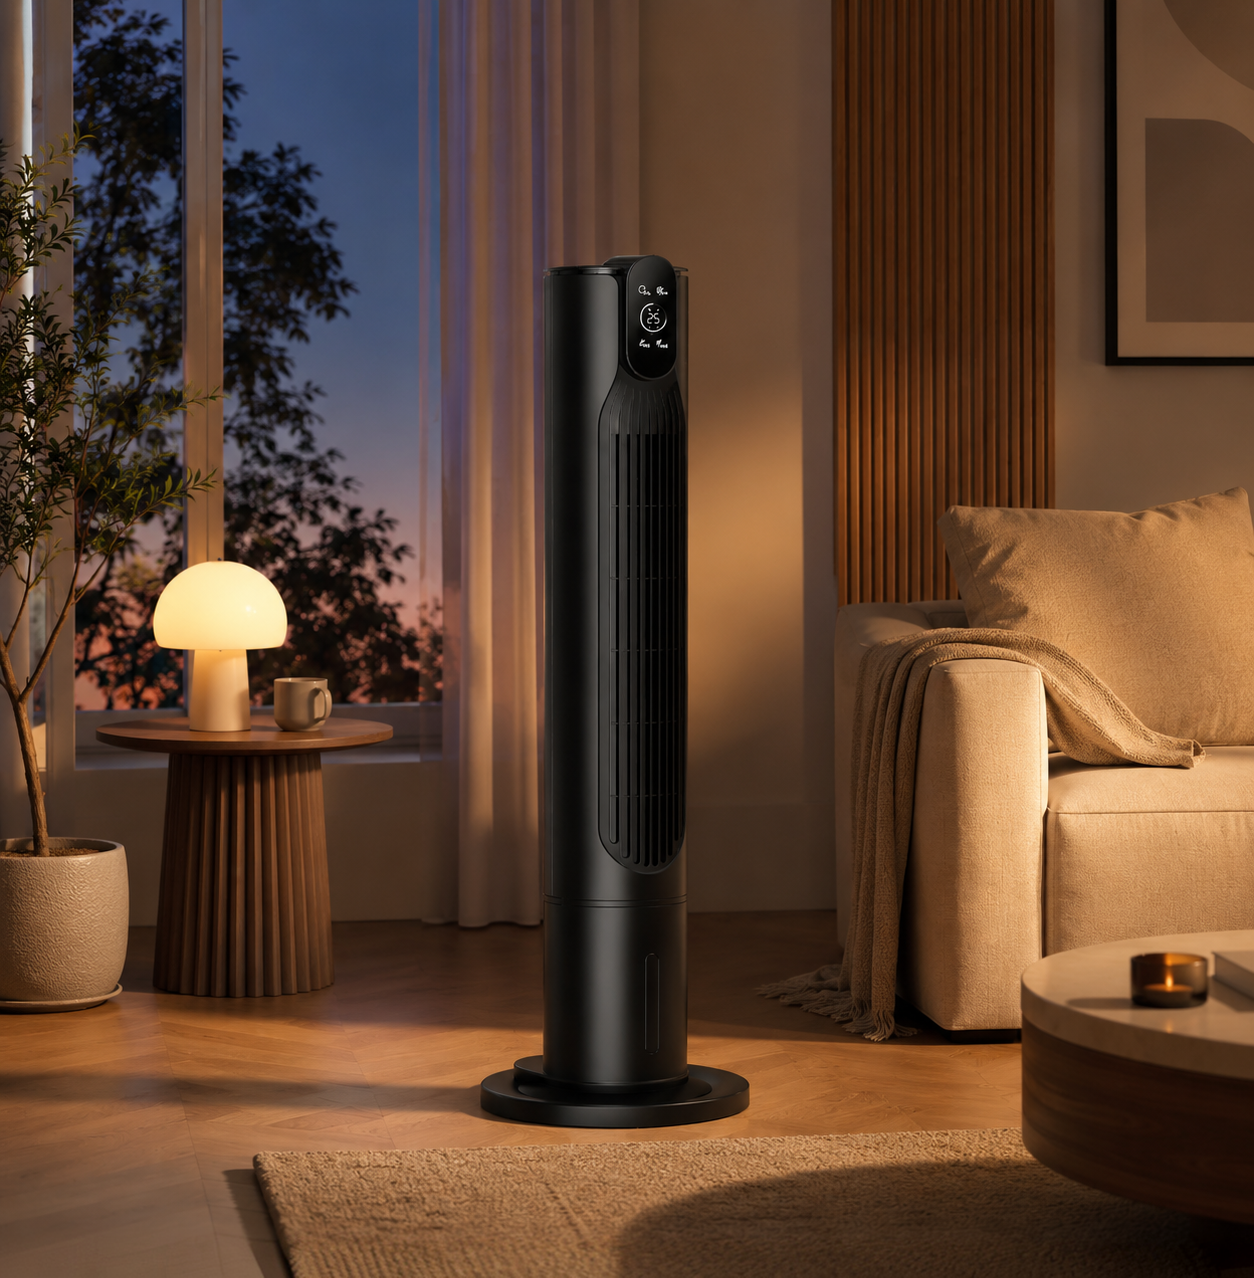
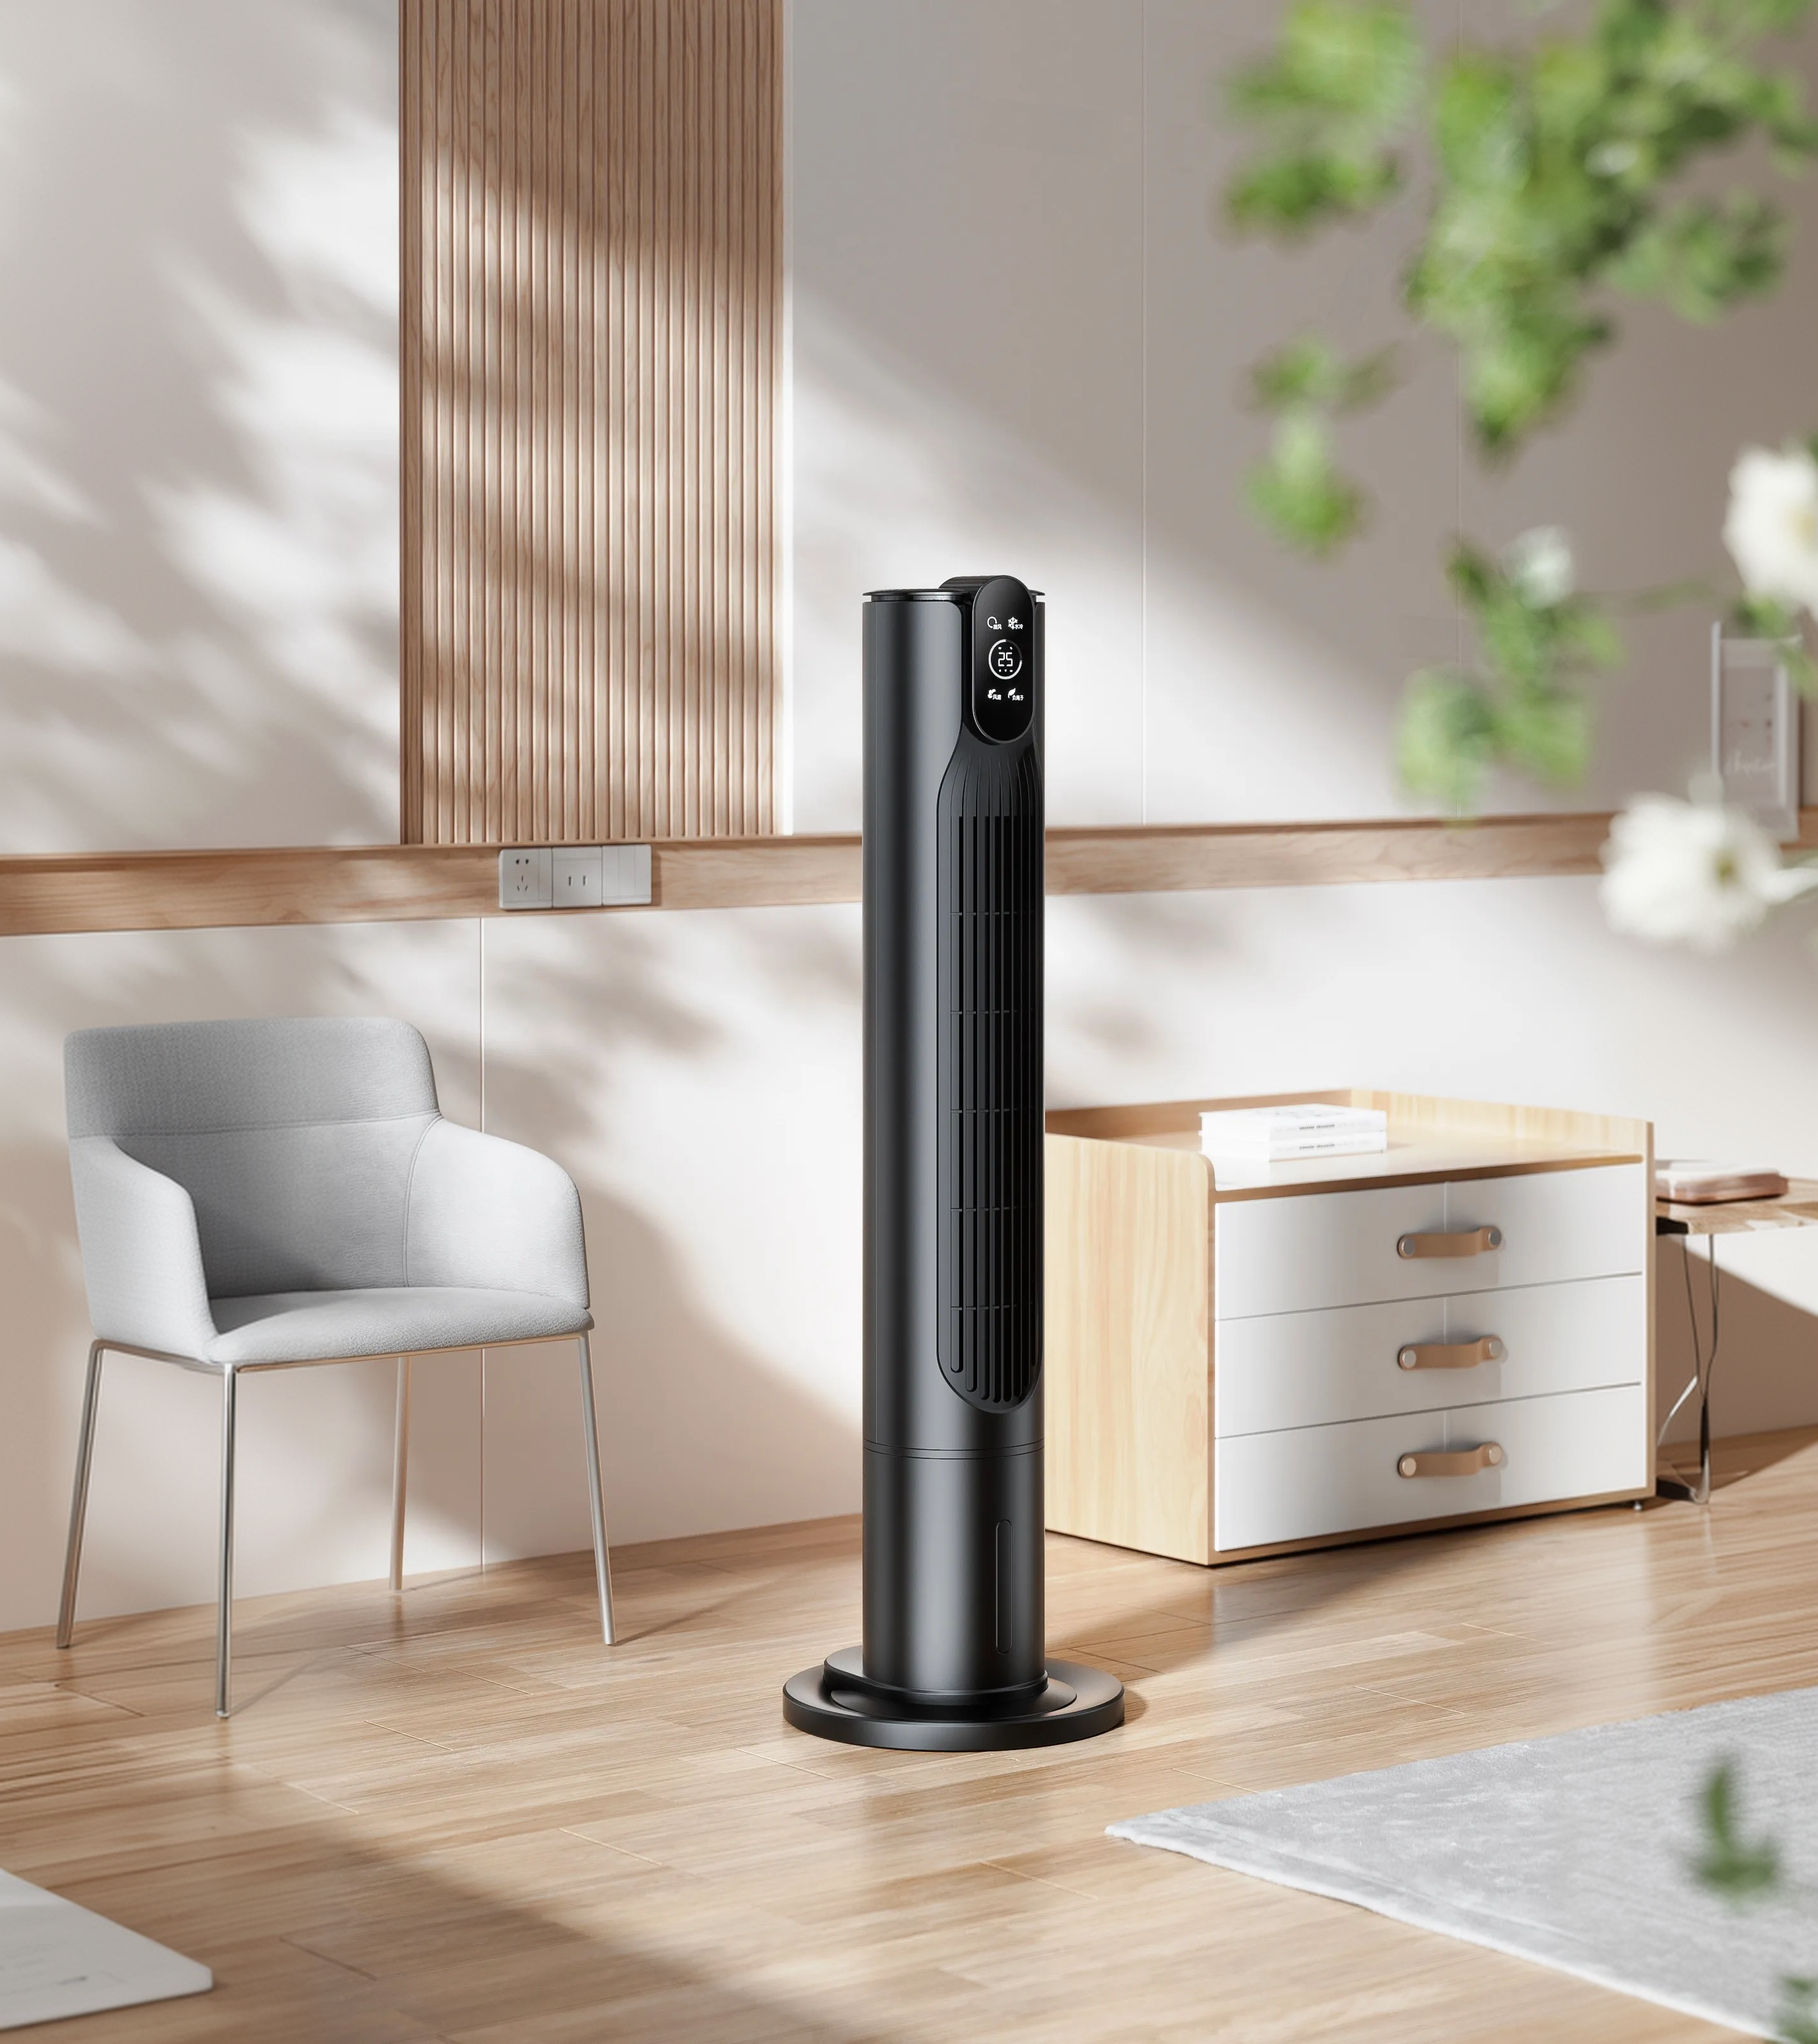
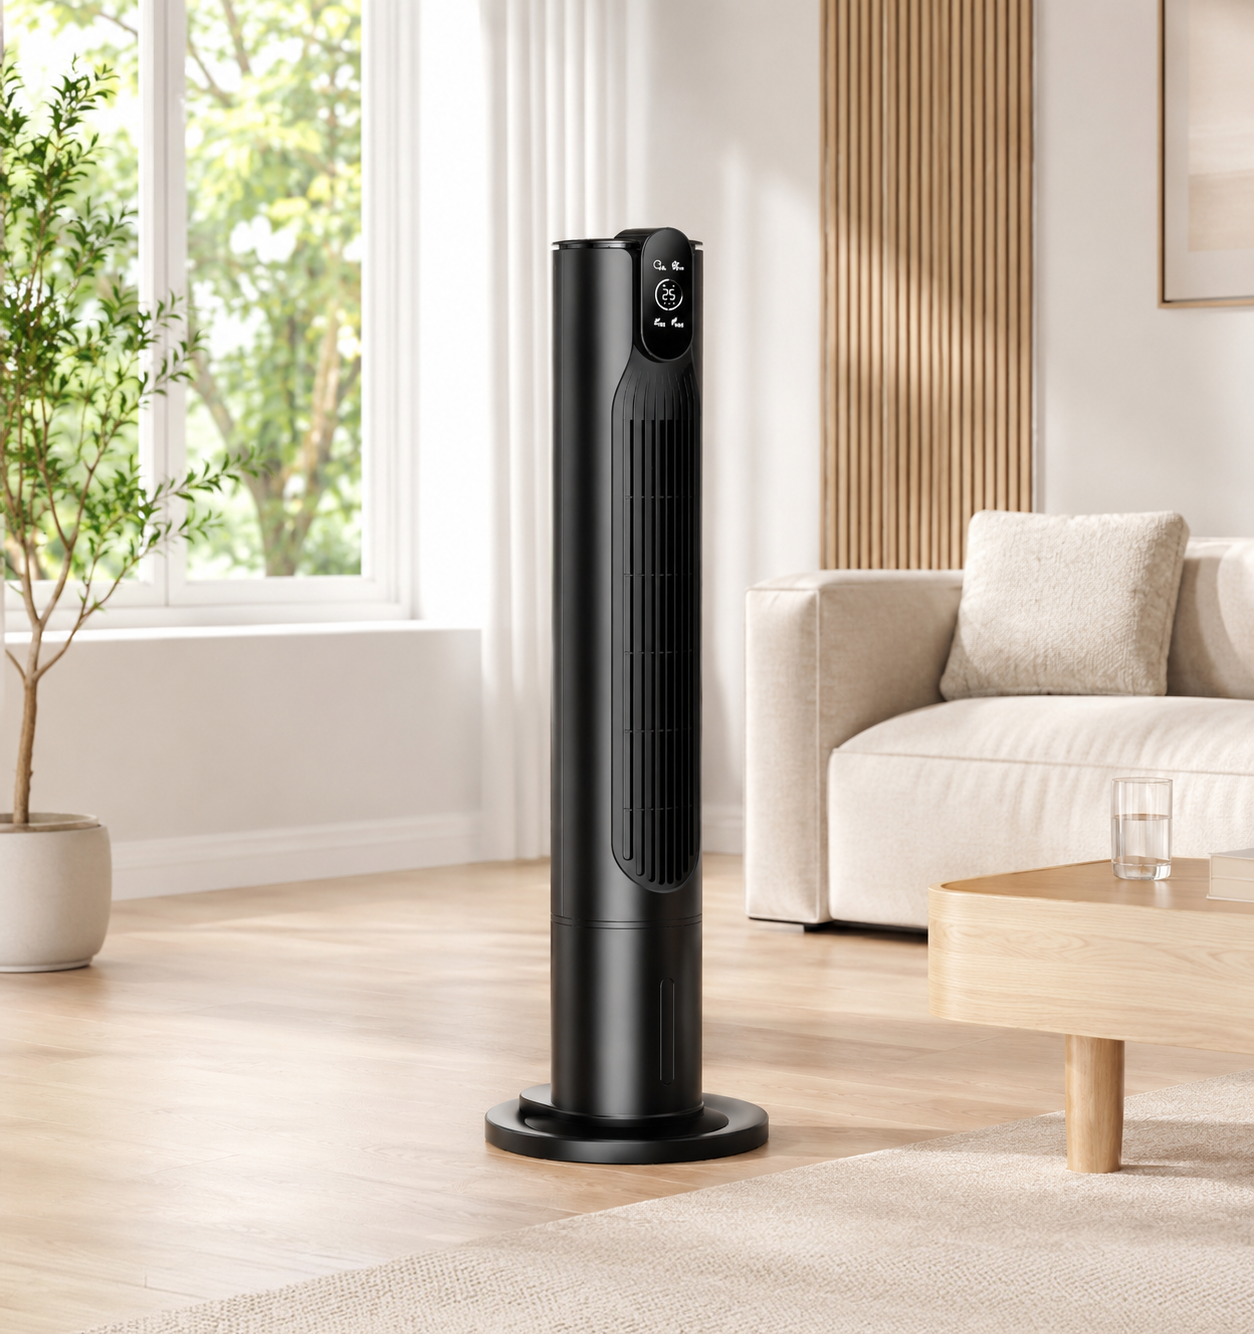
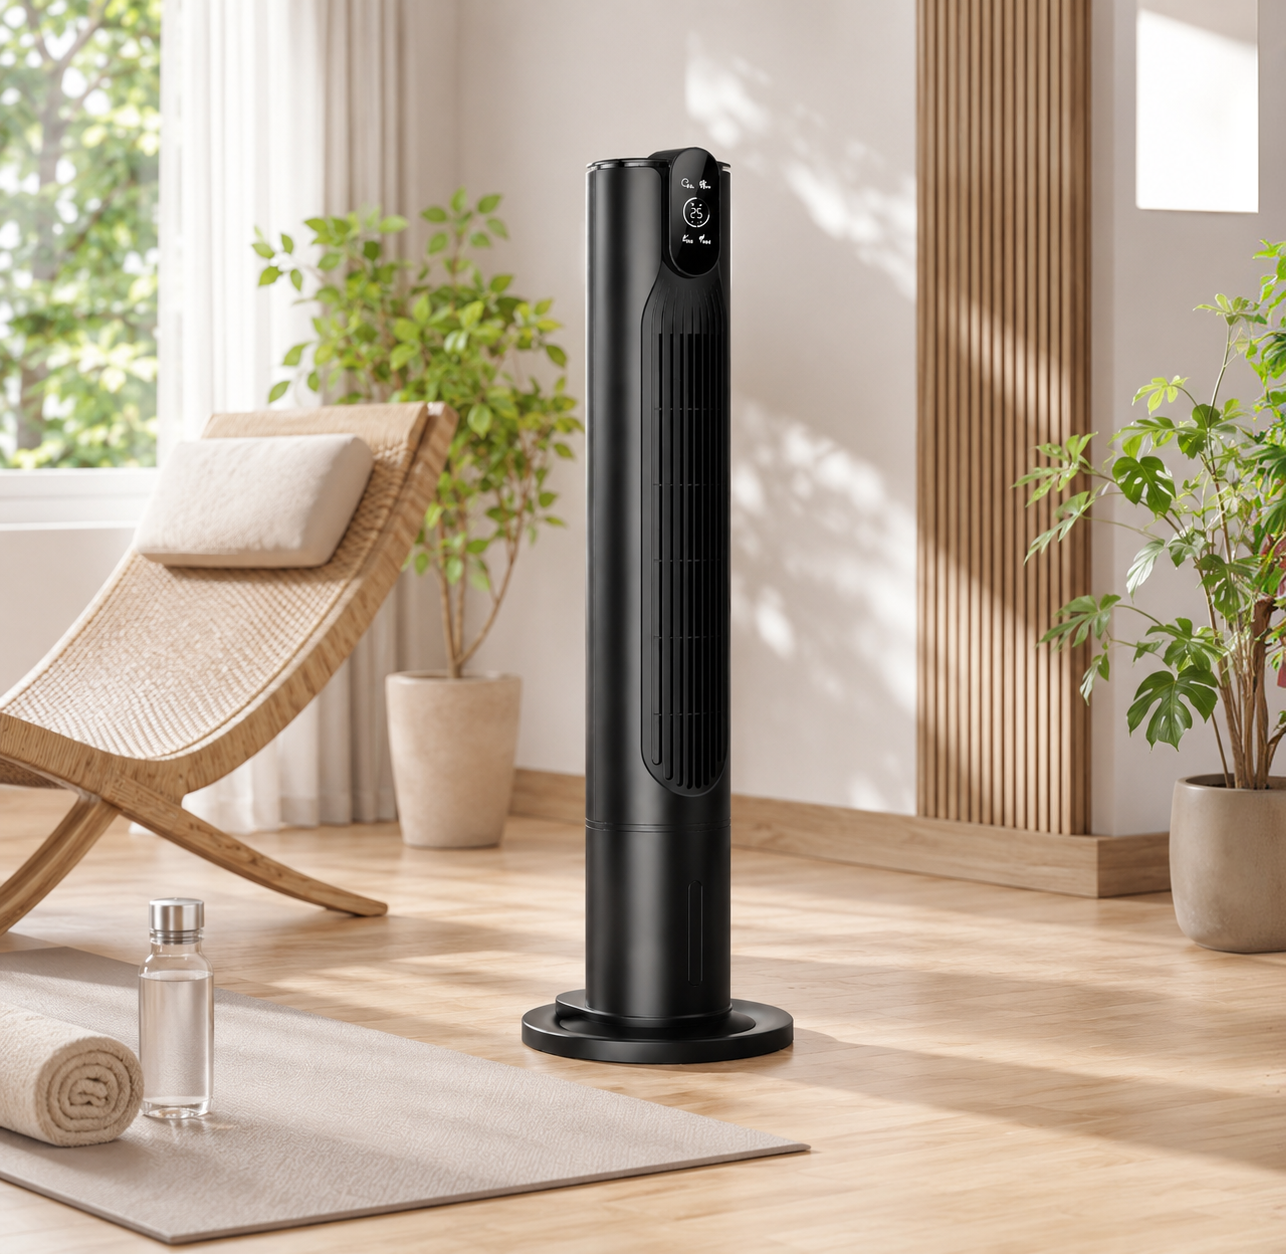
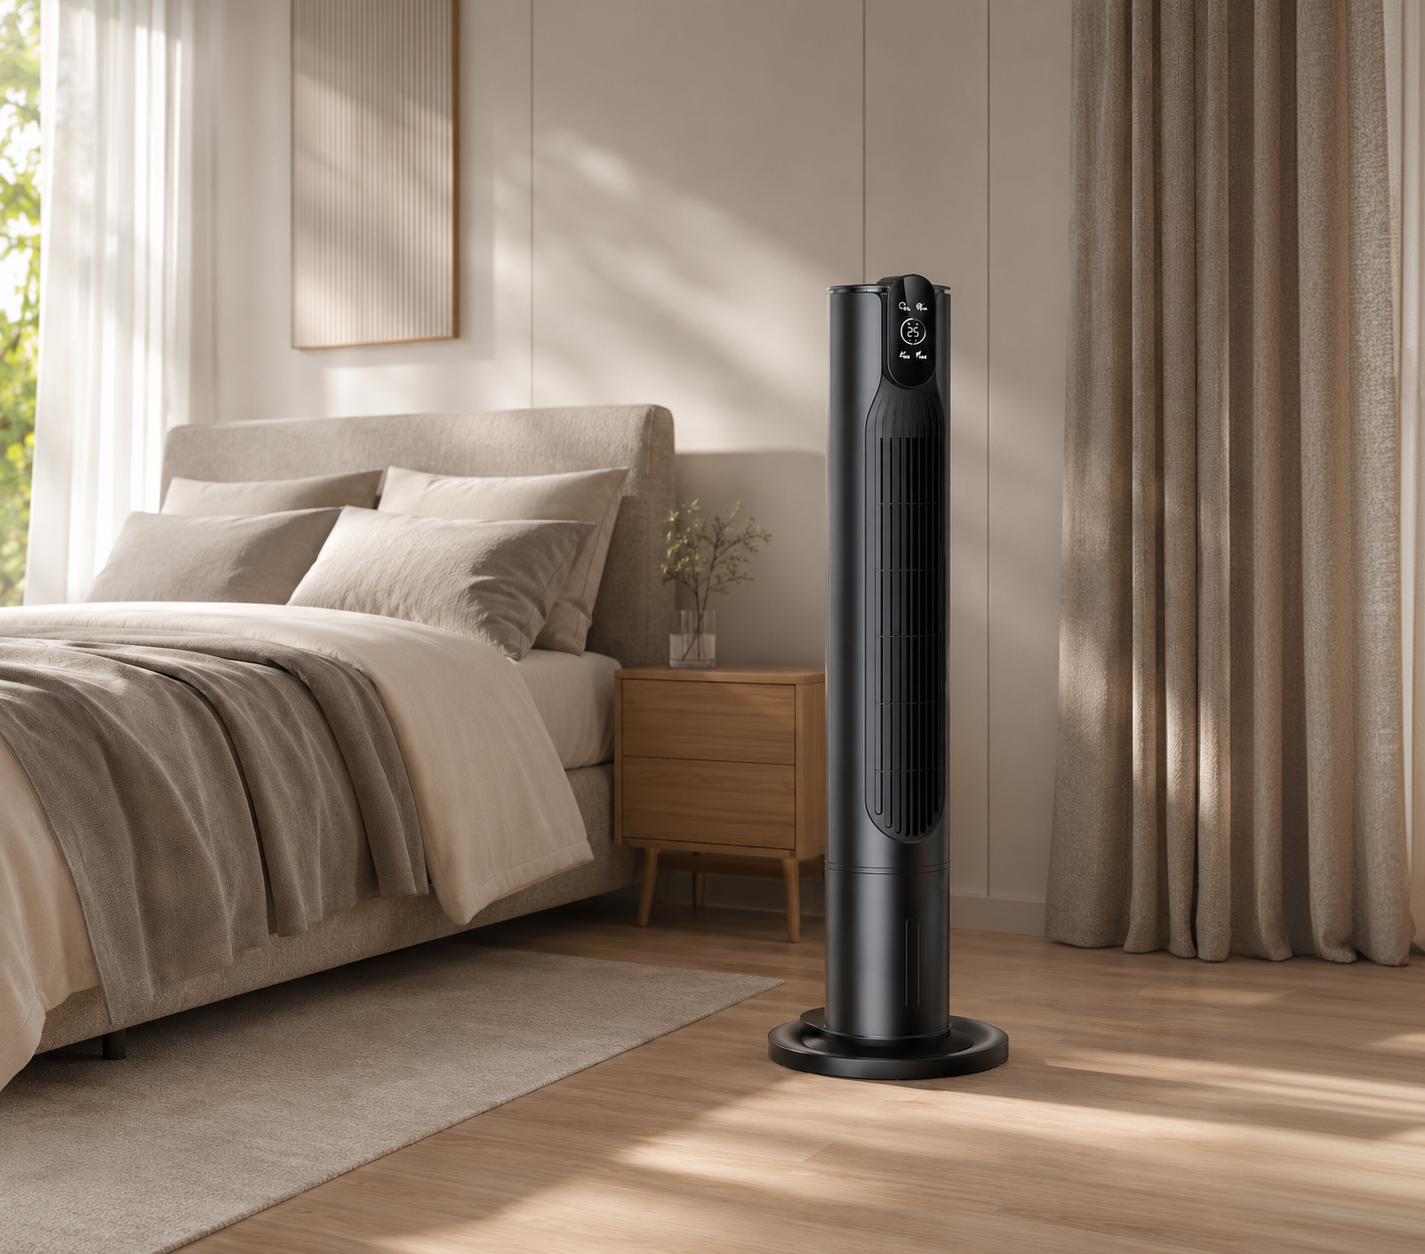
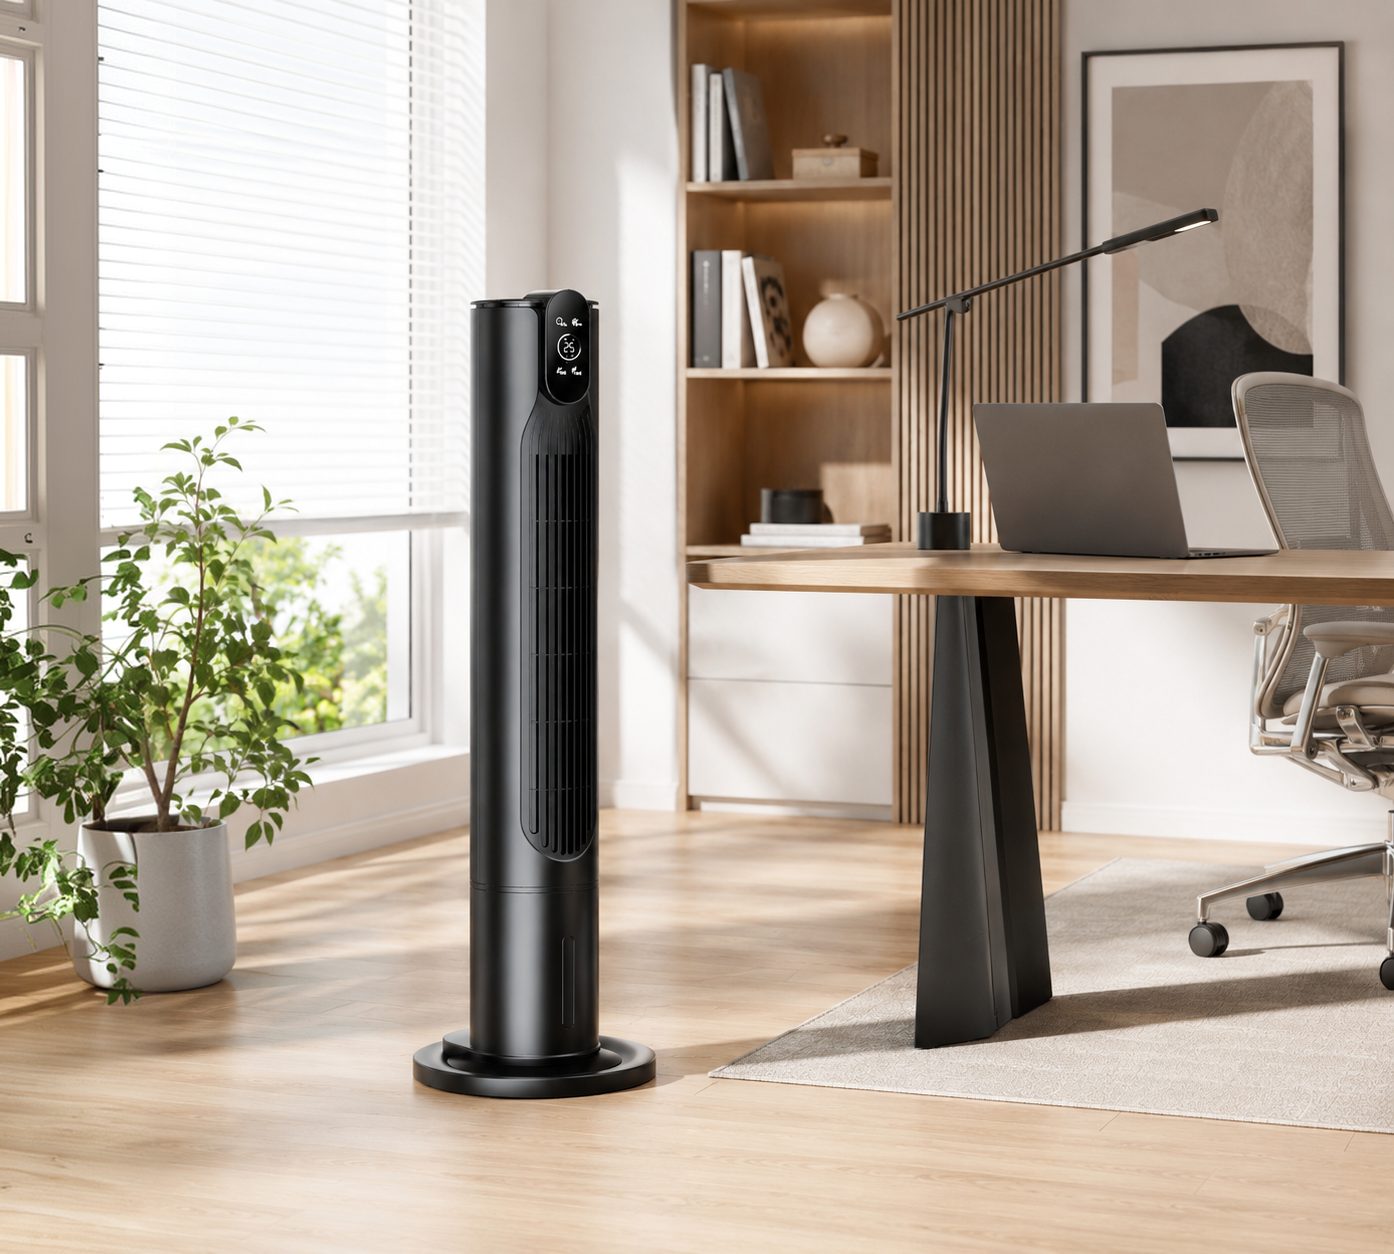
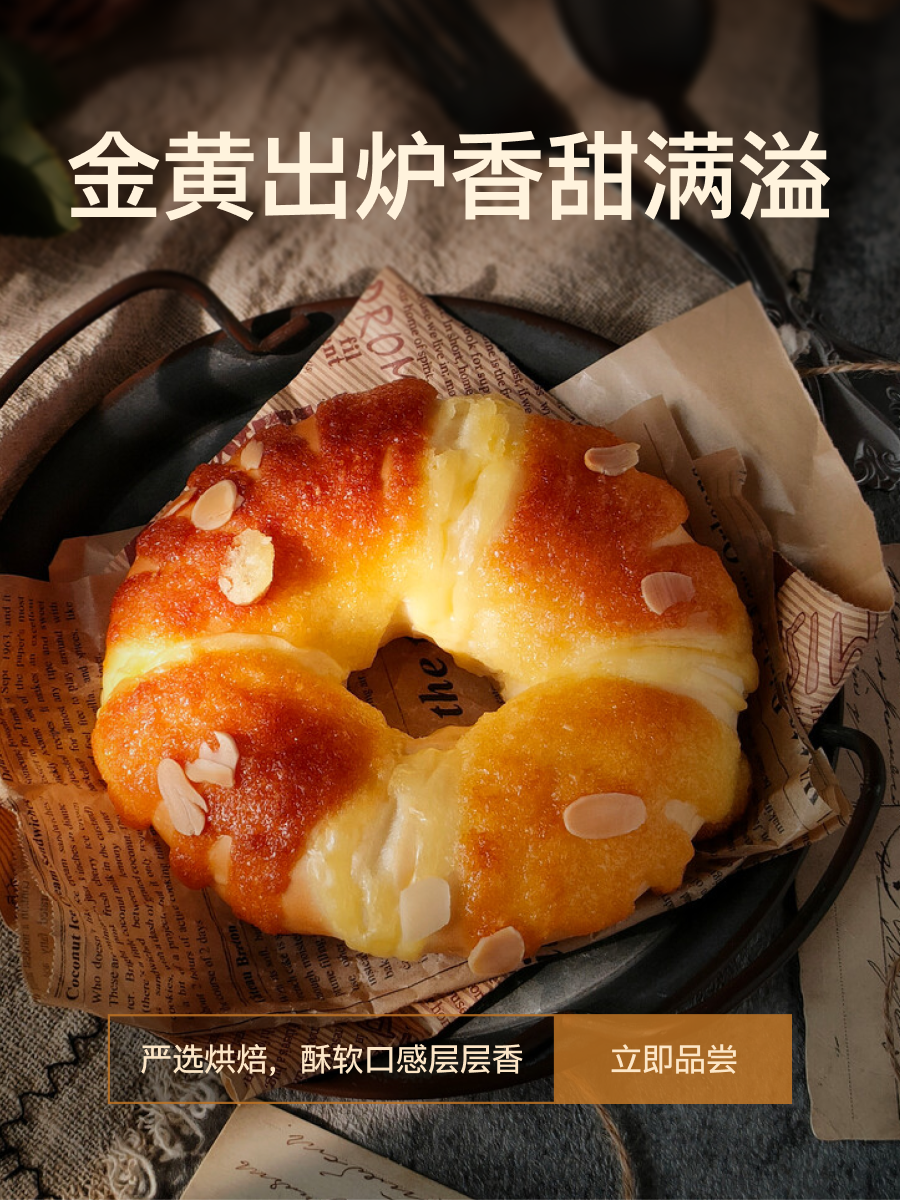
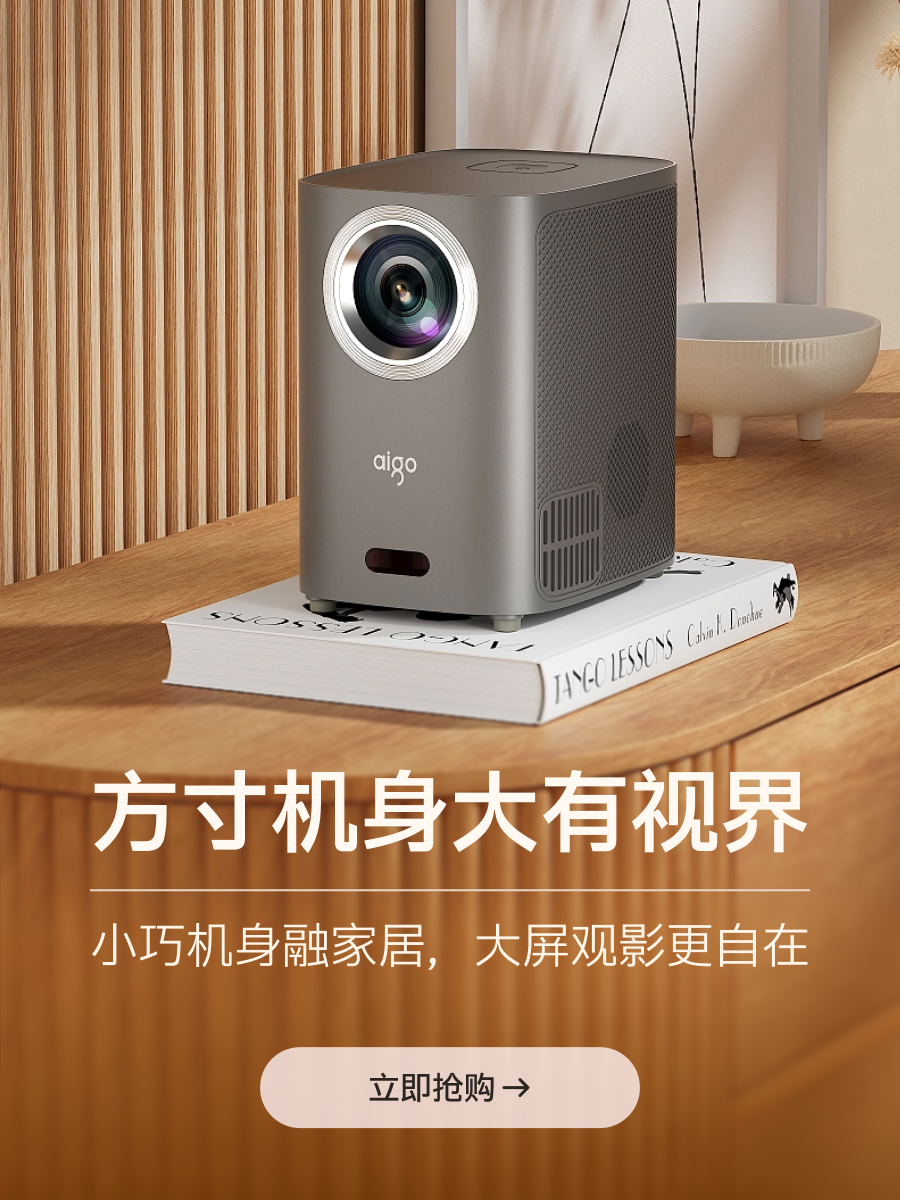
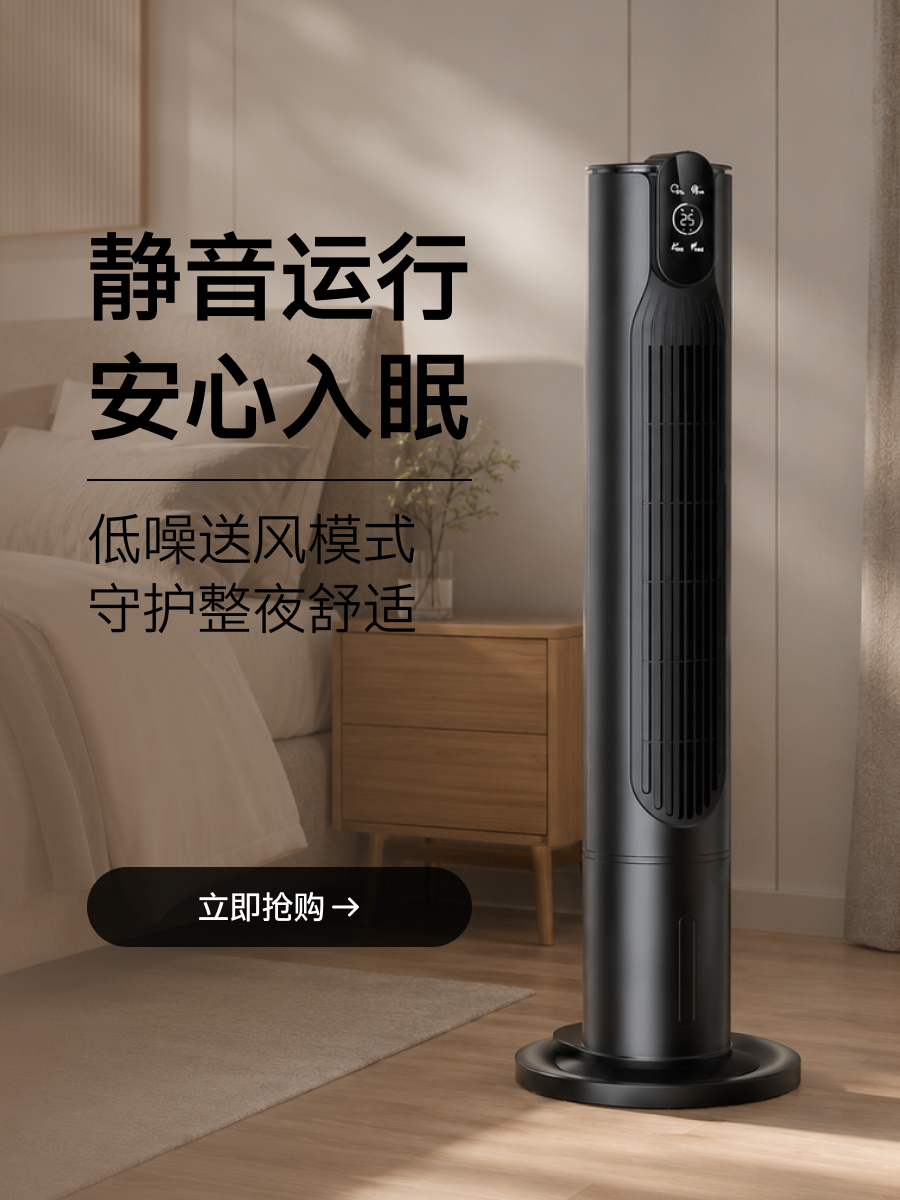
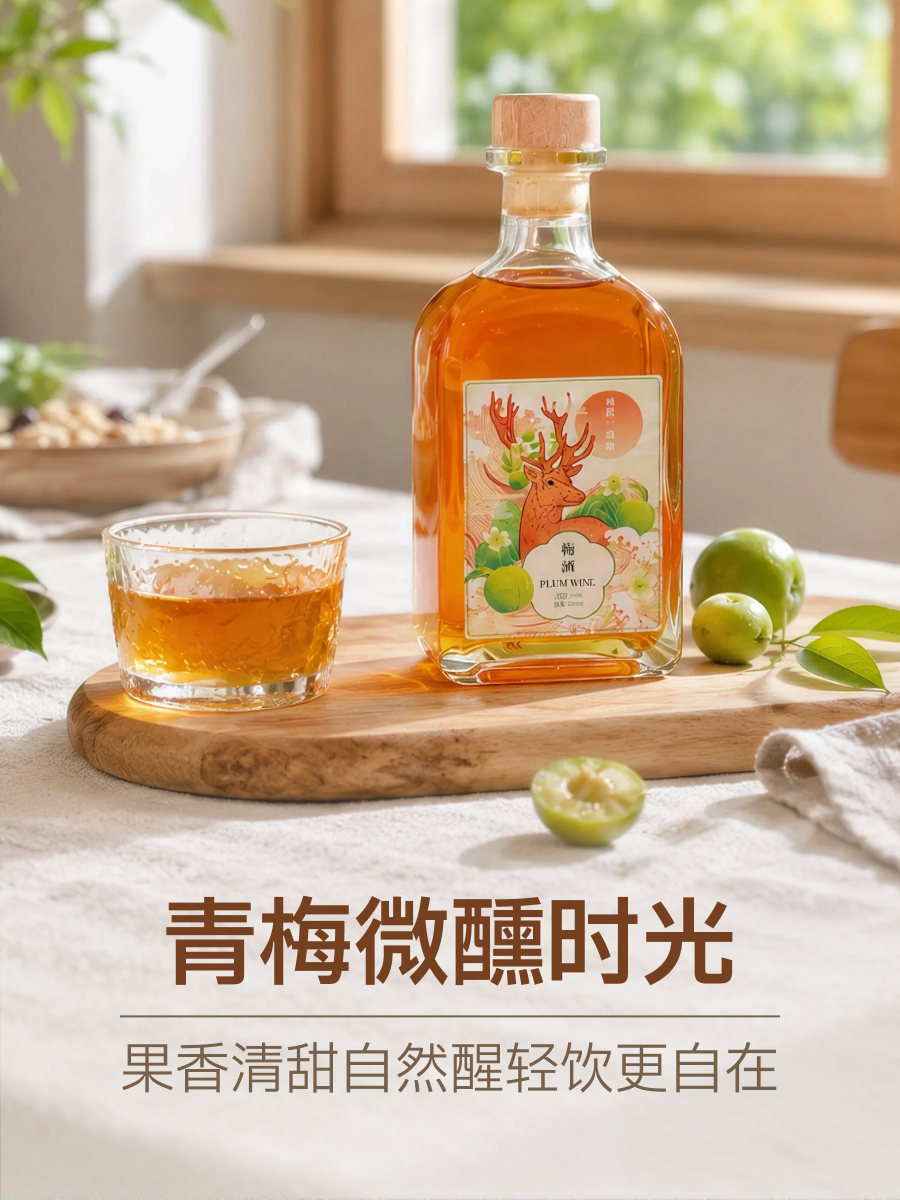
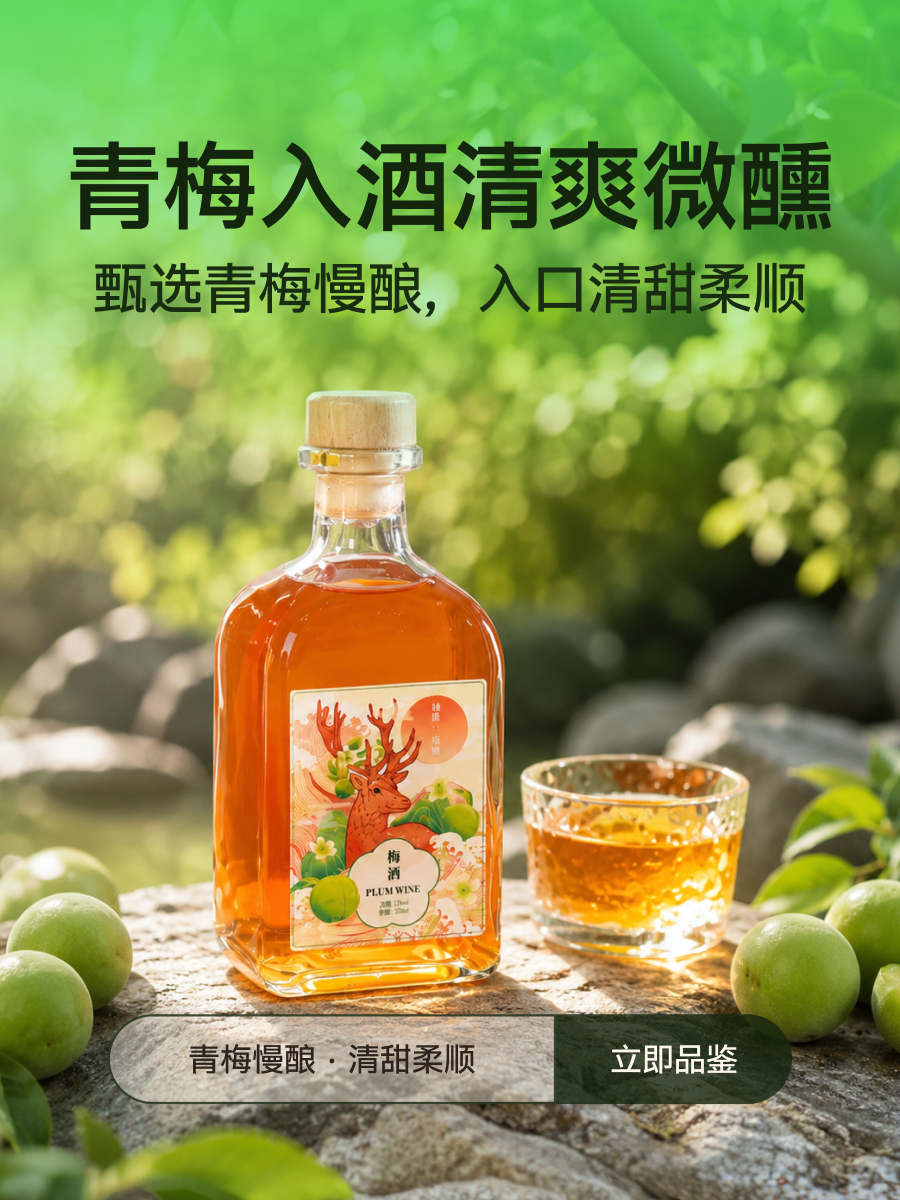
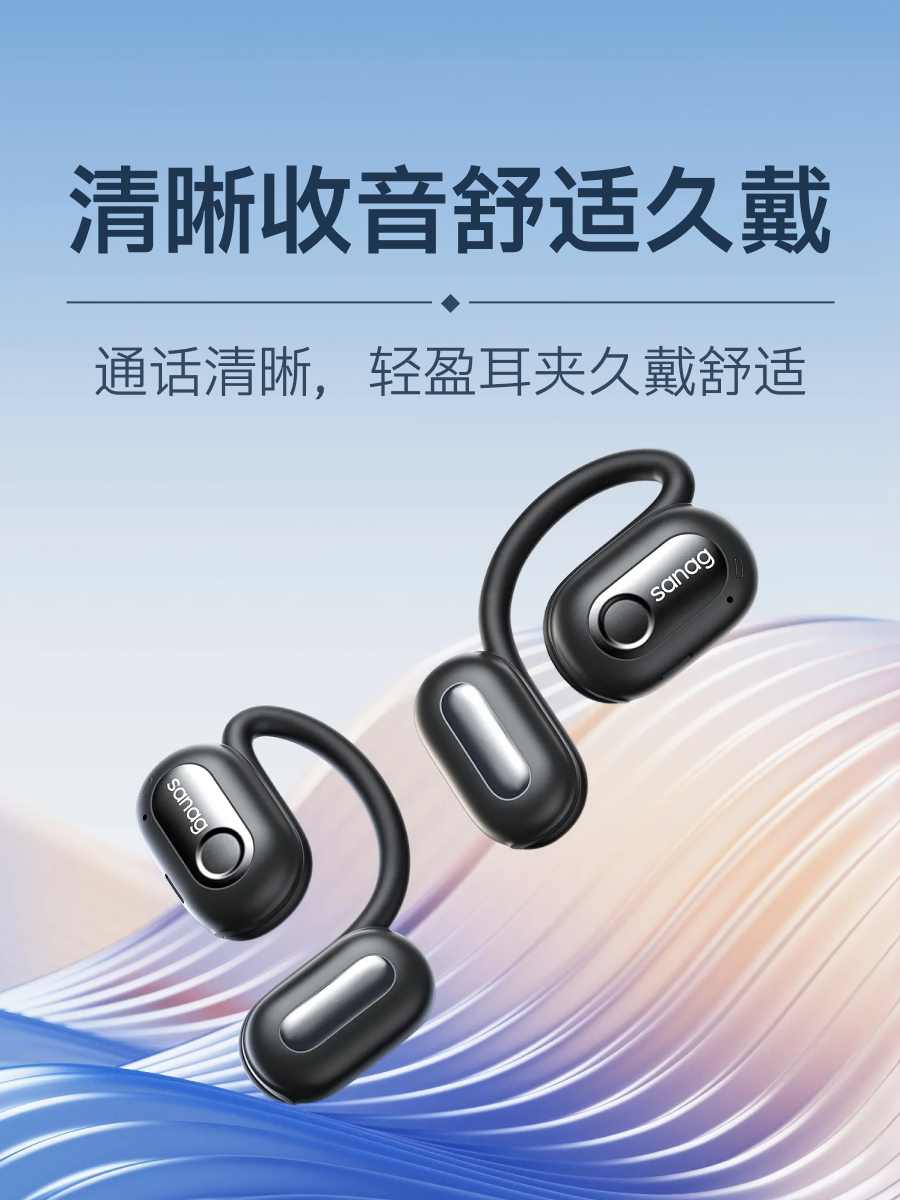
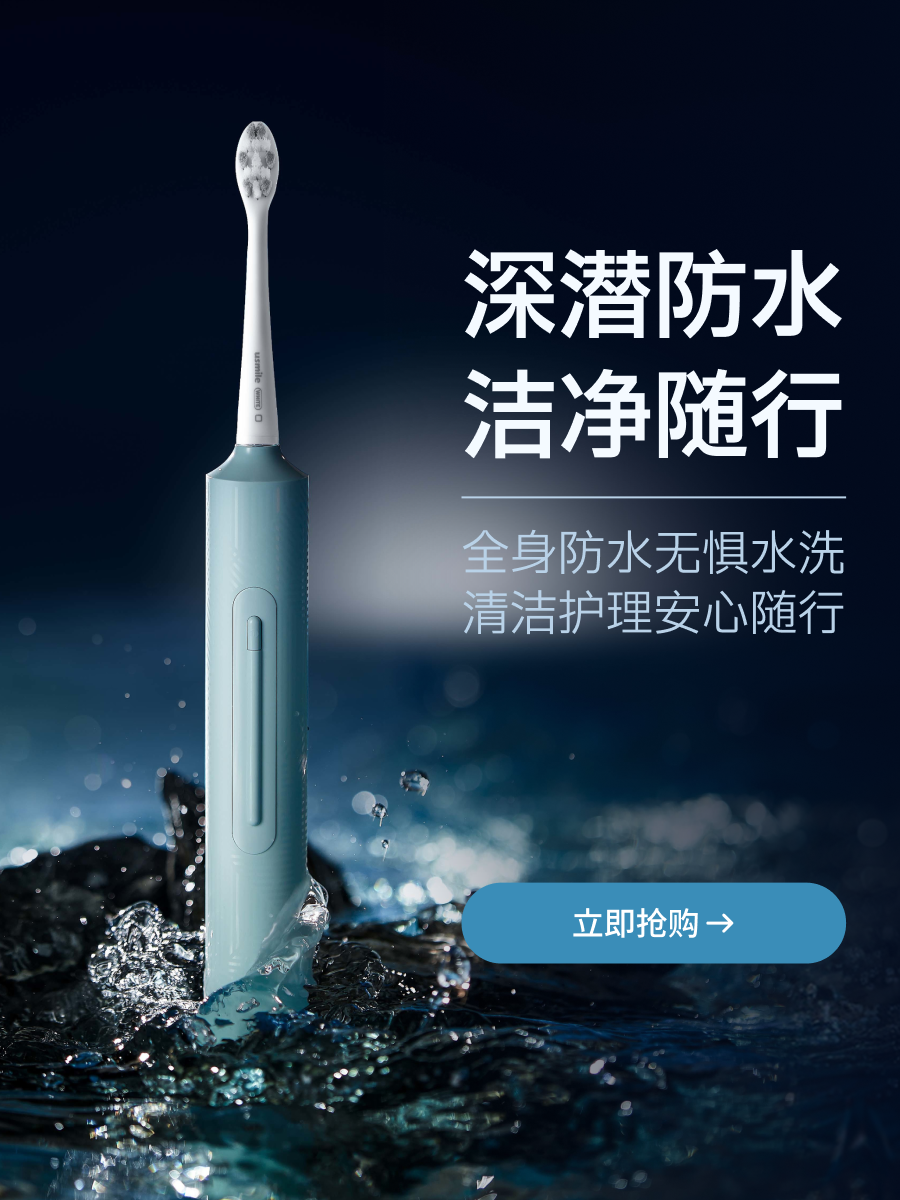
10.5+
 SKU多样性提升
14.5
消费占比
01 / 项目背景
从"多品 1 图"到"1 品多图":商品图生产的规模化转折
2023 年,各公司开始尝试用 AI 解决商业问题。京东中小商家体量庞大,大部分没有专业拍摄团队做产品包装;618、双 11、双 12 等大促活动频繁,商家需要大批量替换商品图背景来匹配不同营销语境。项目用 AI 方式系统性地解决这个问题,把商品图从"多品 1 图"推进到"1 品多图"。
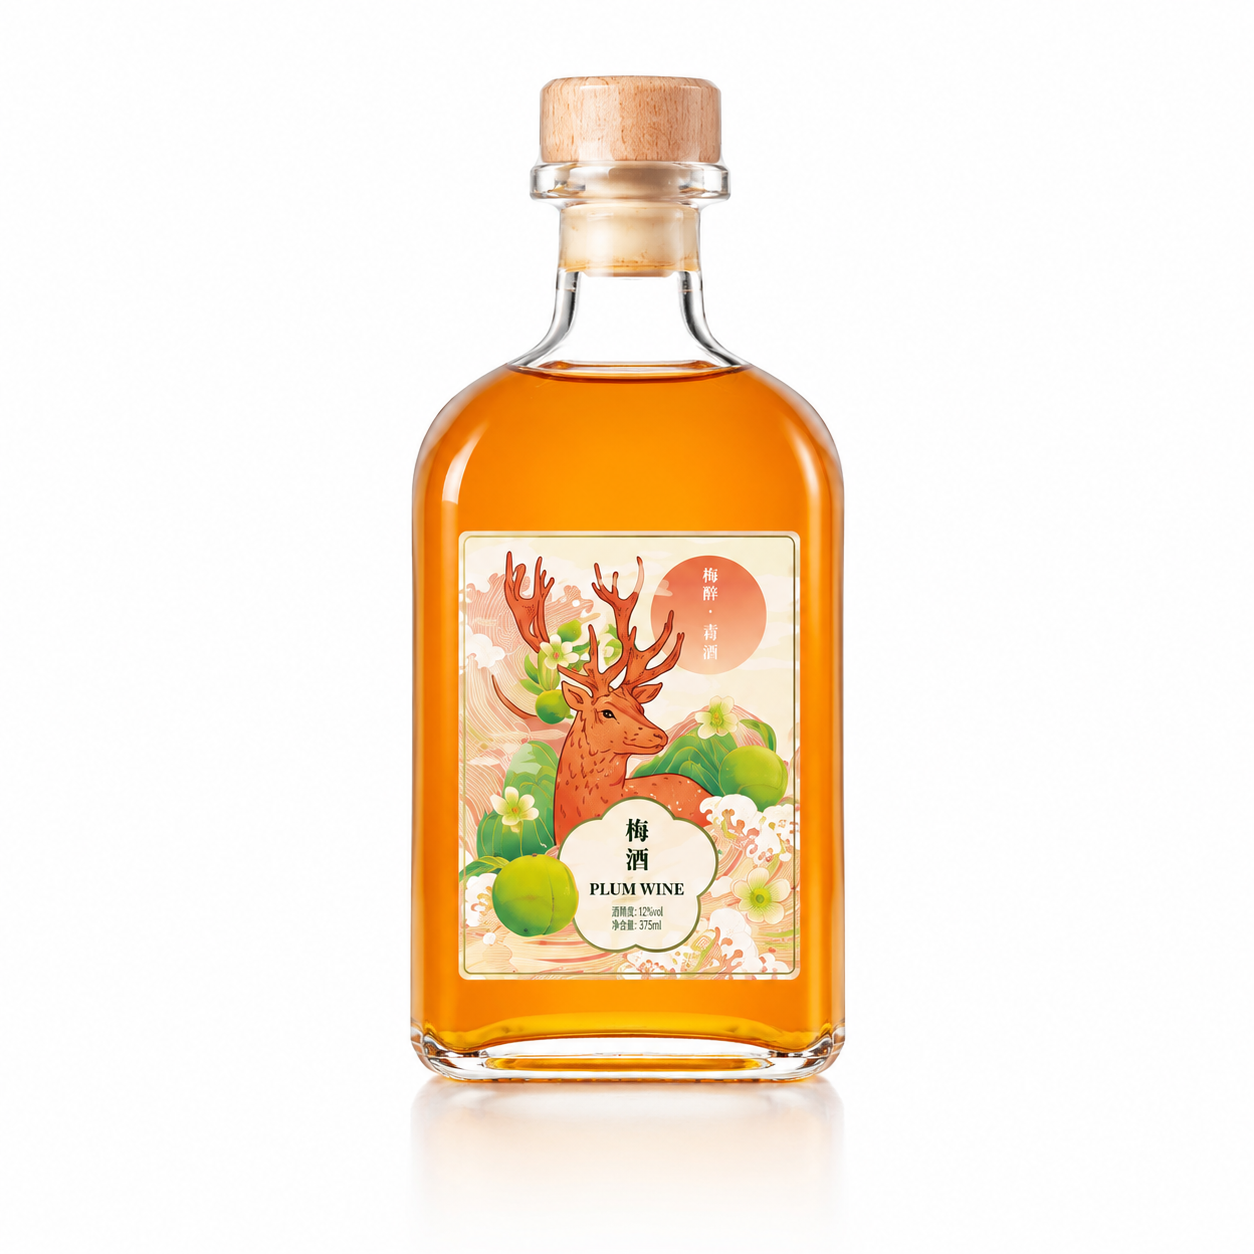
Before
多品 1 图
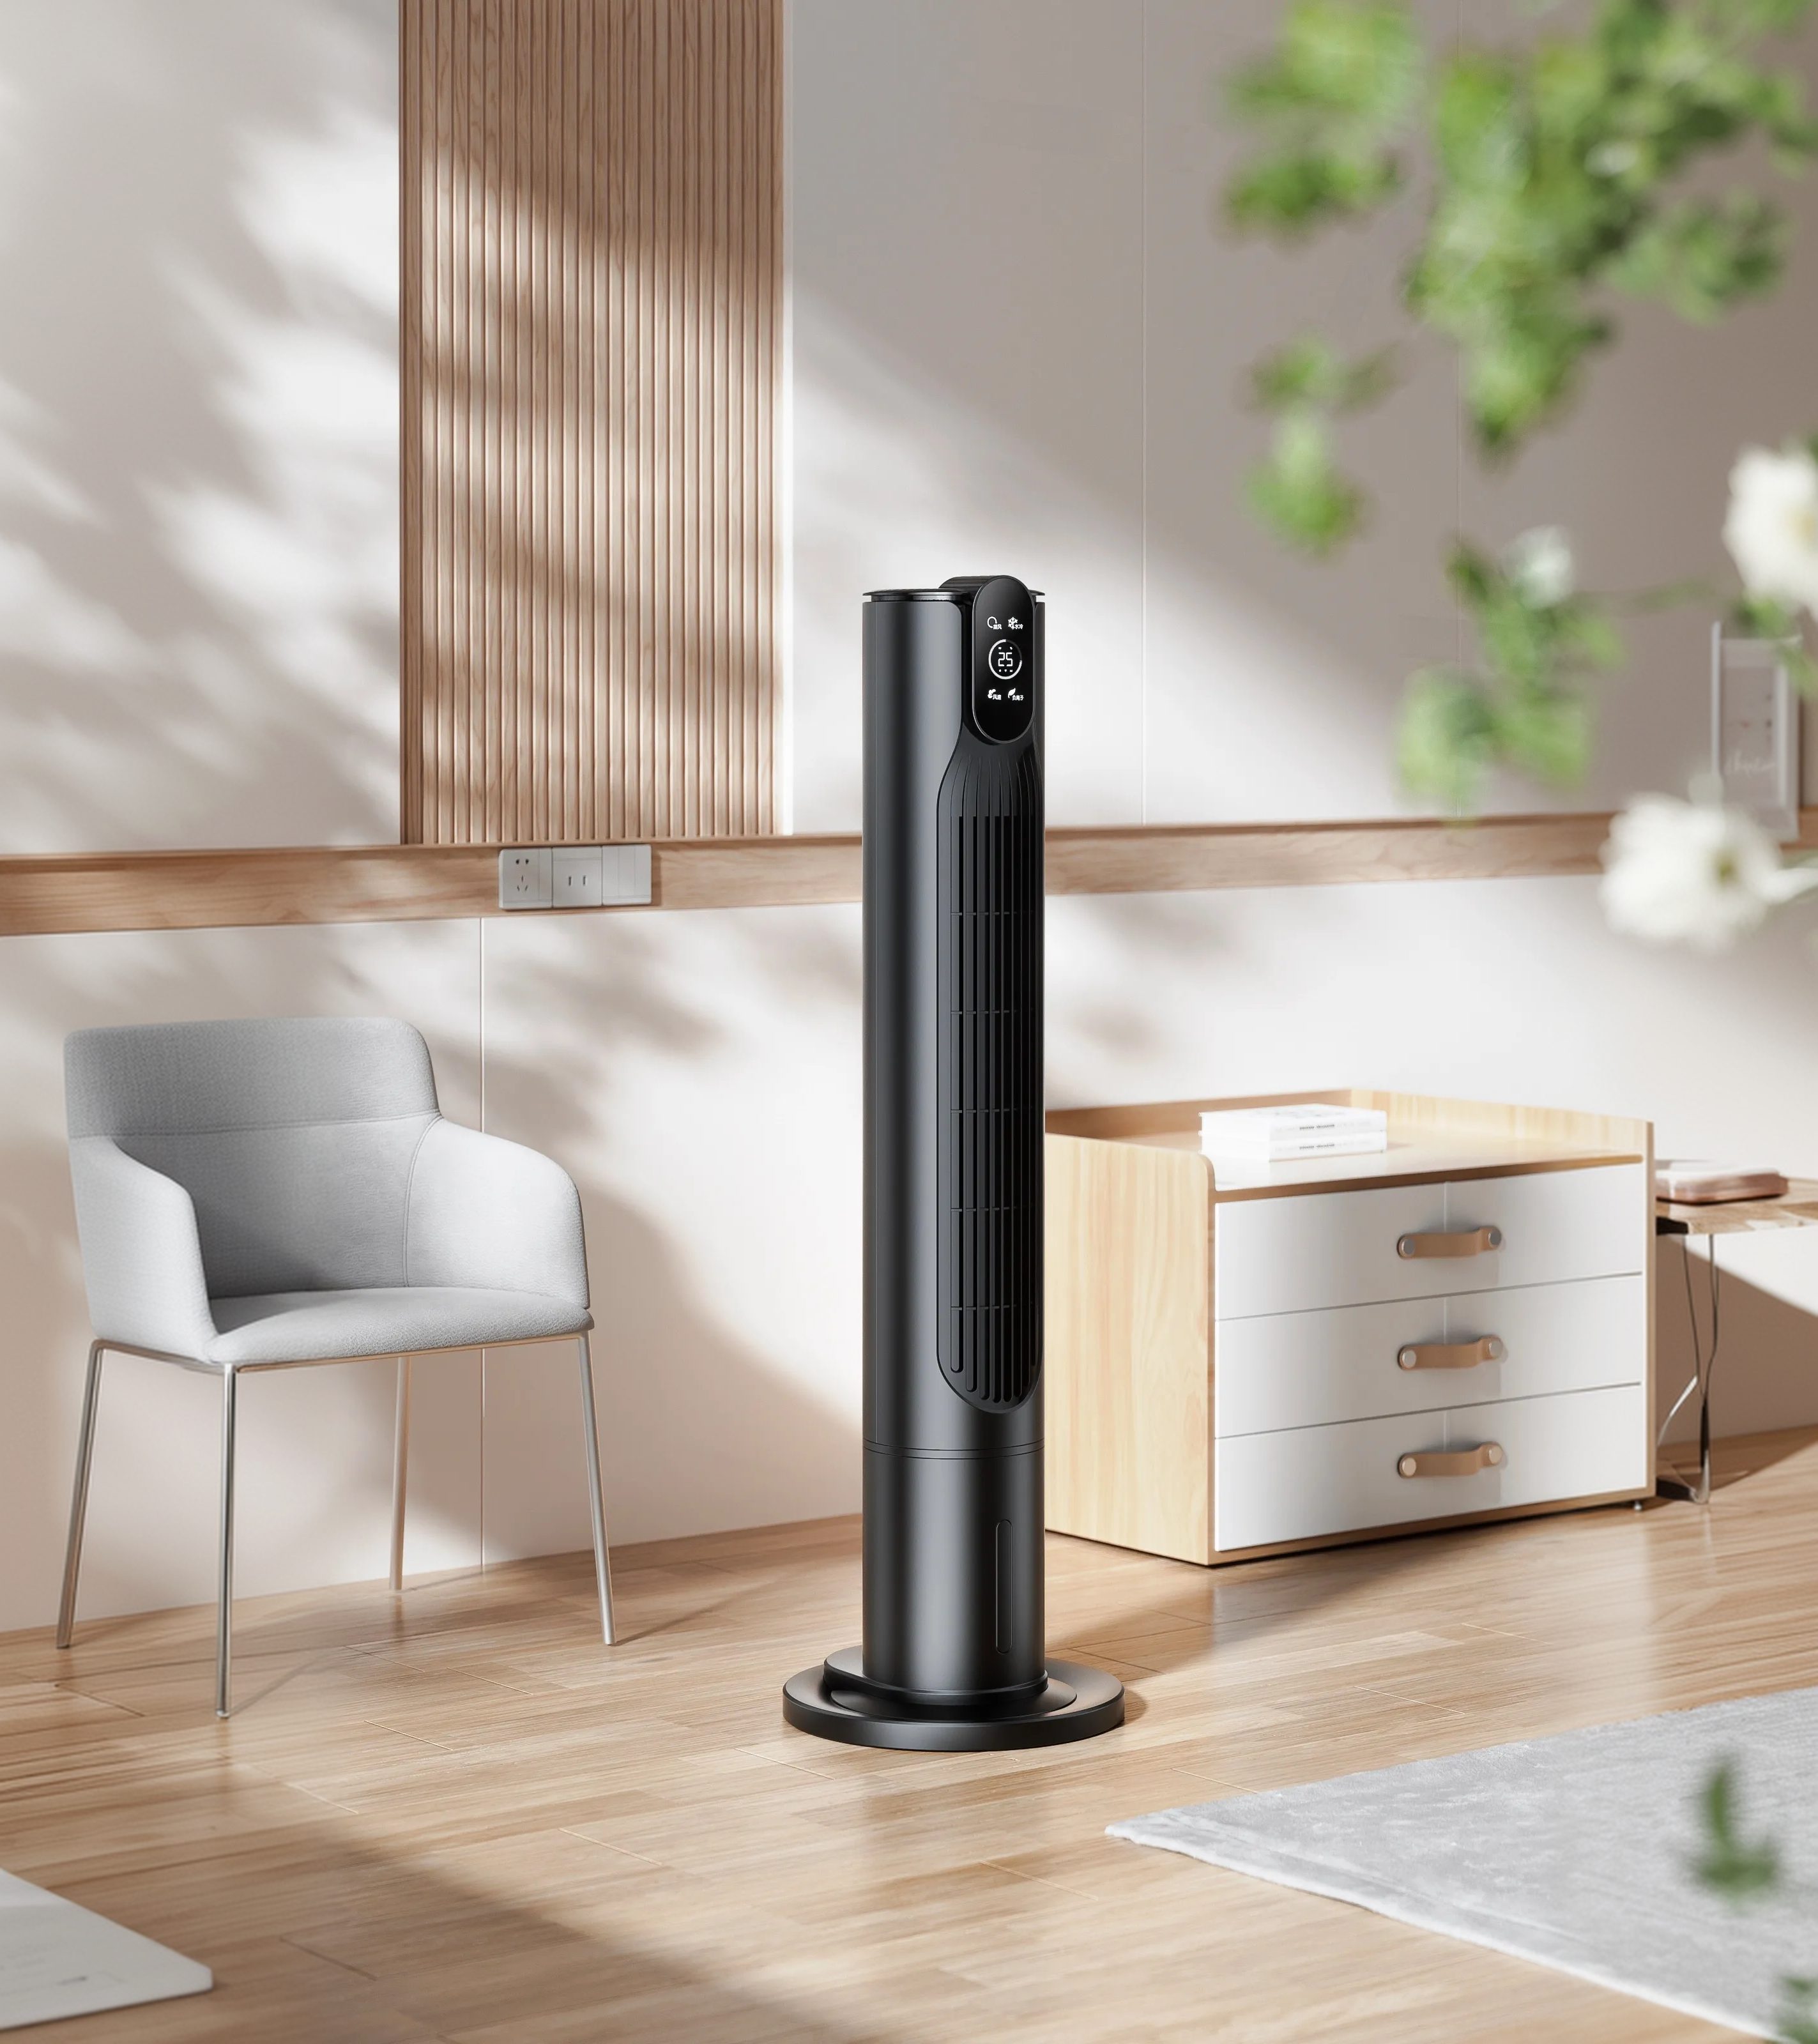
After
1 品多图
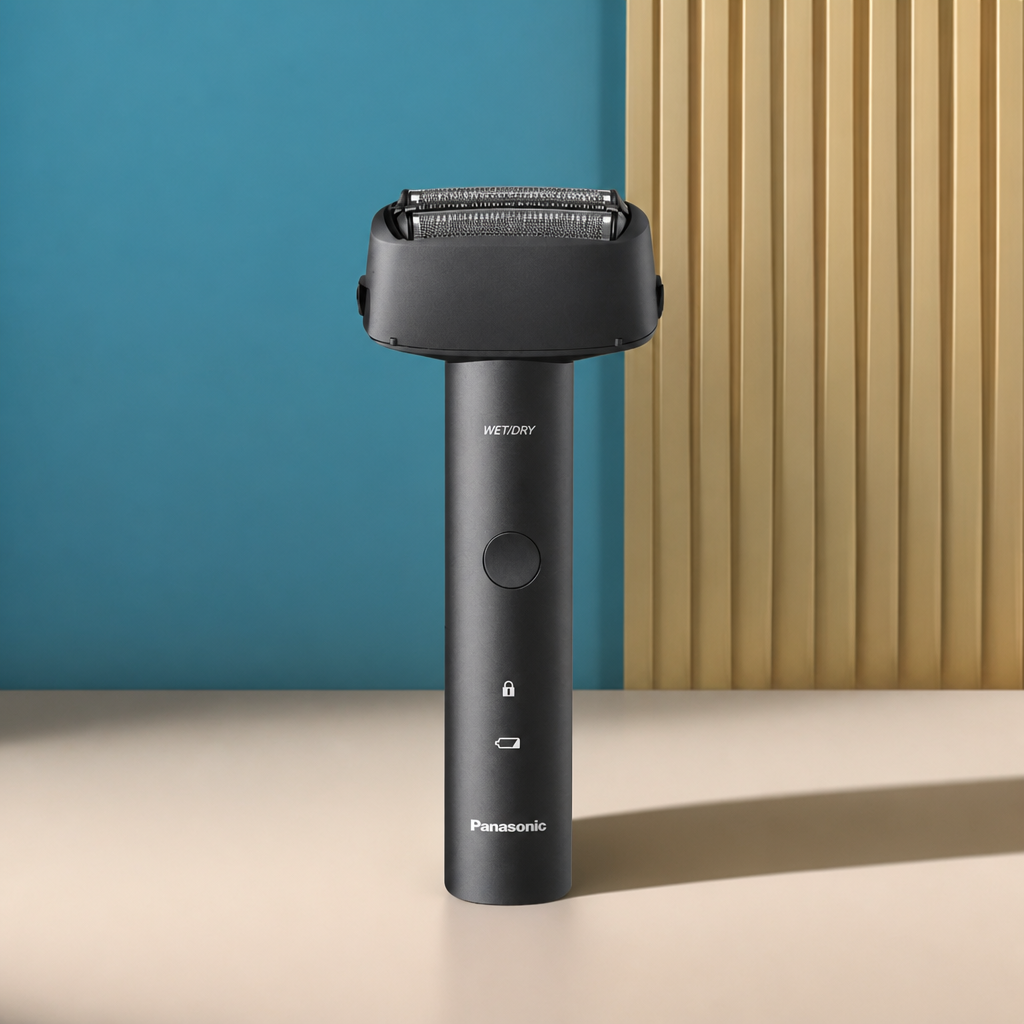
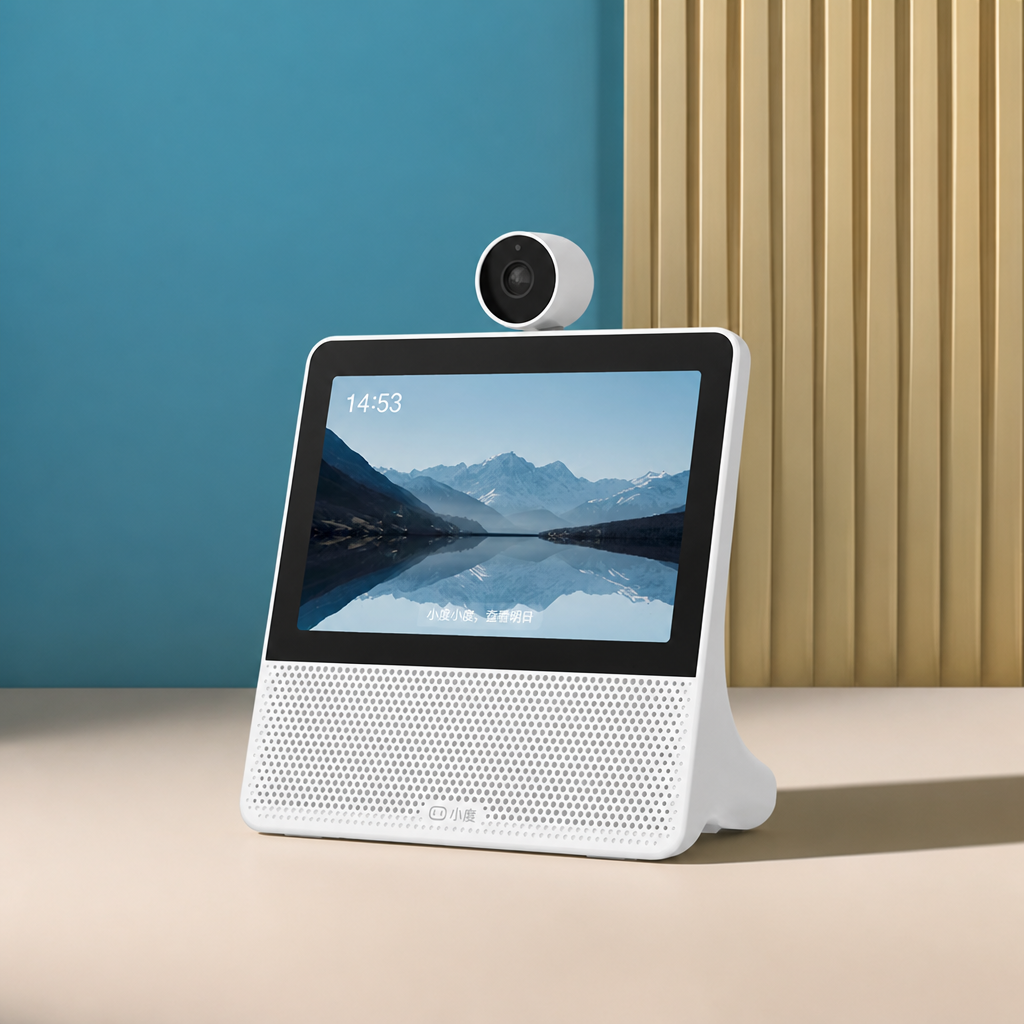
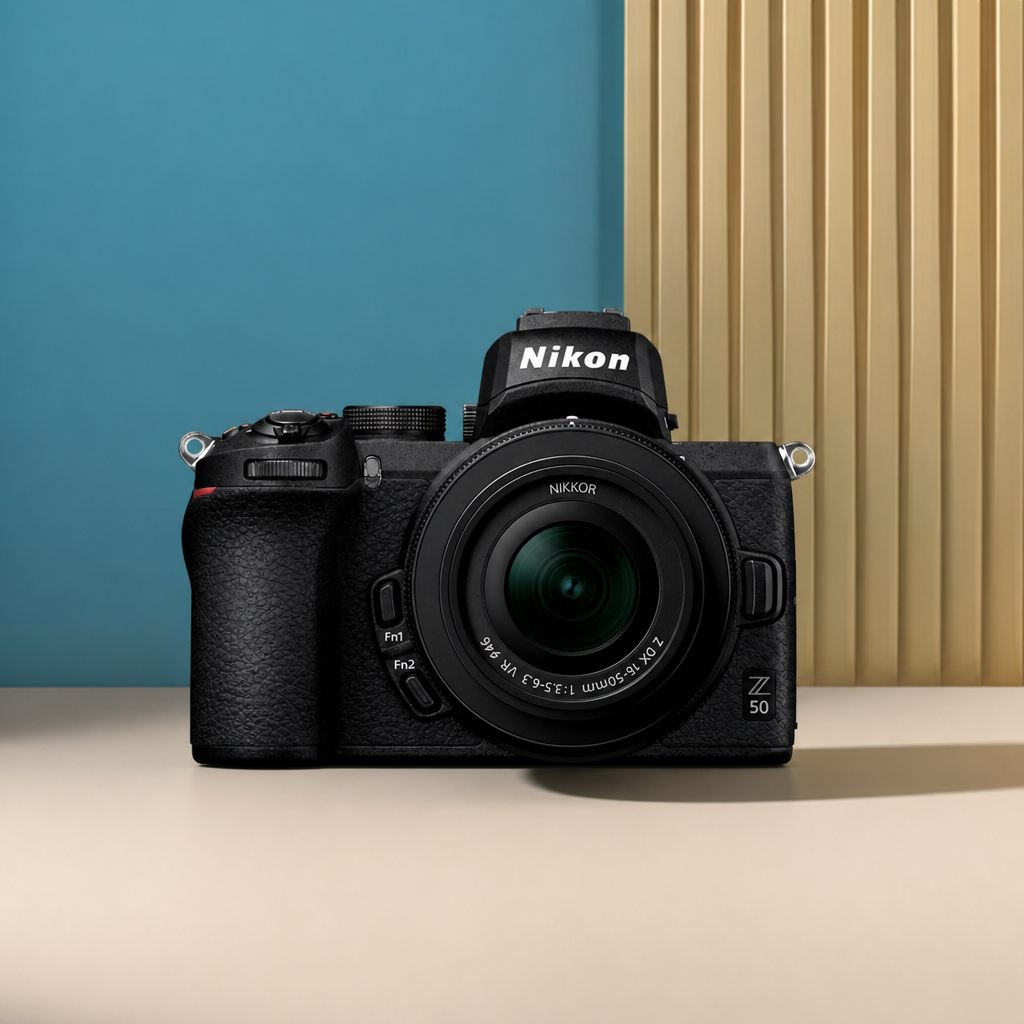
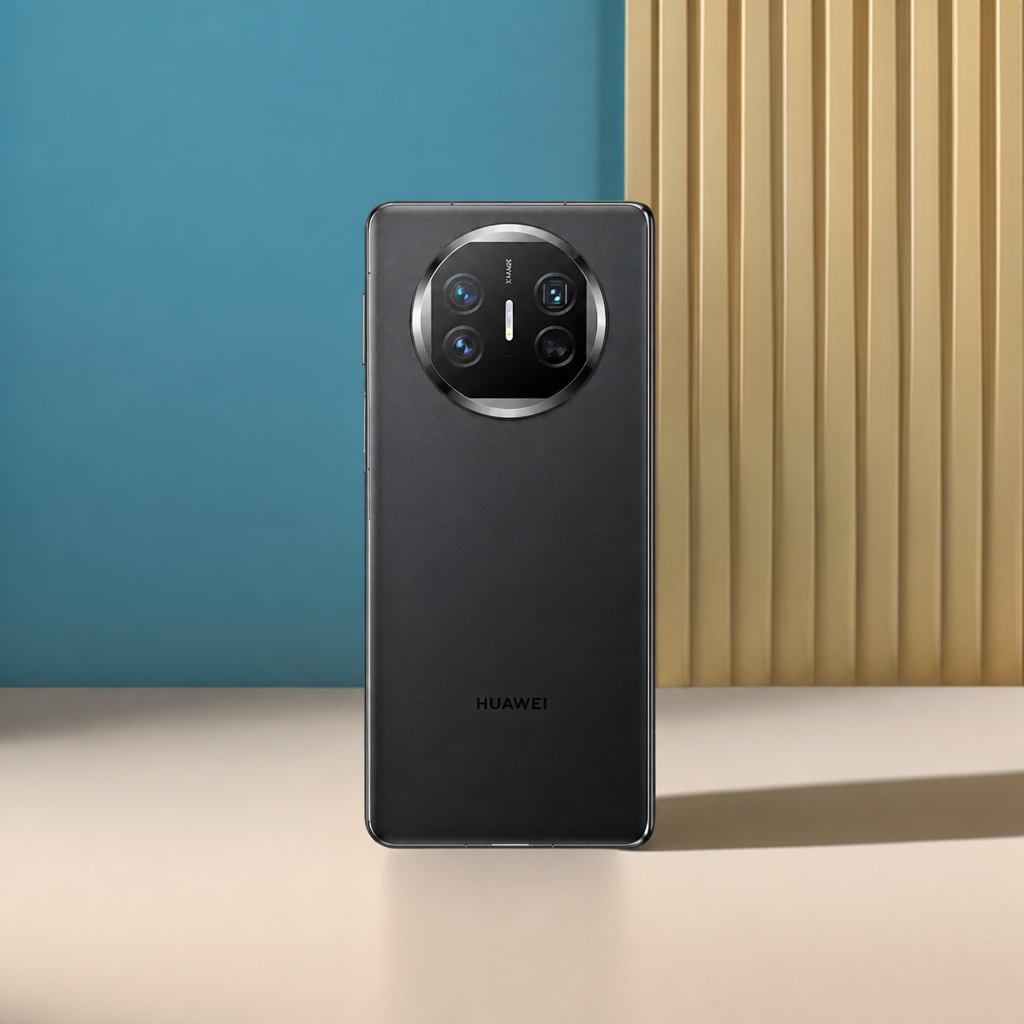
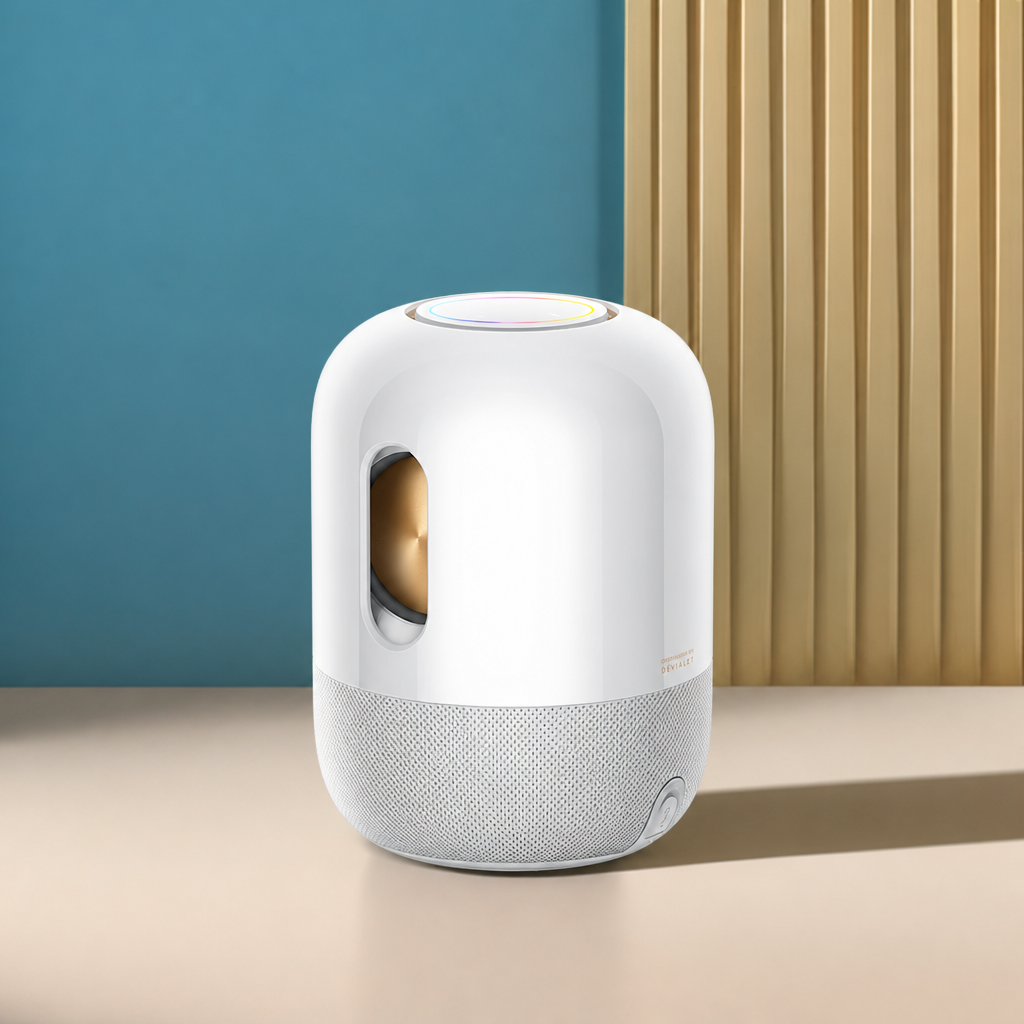
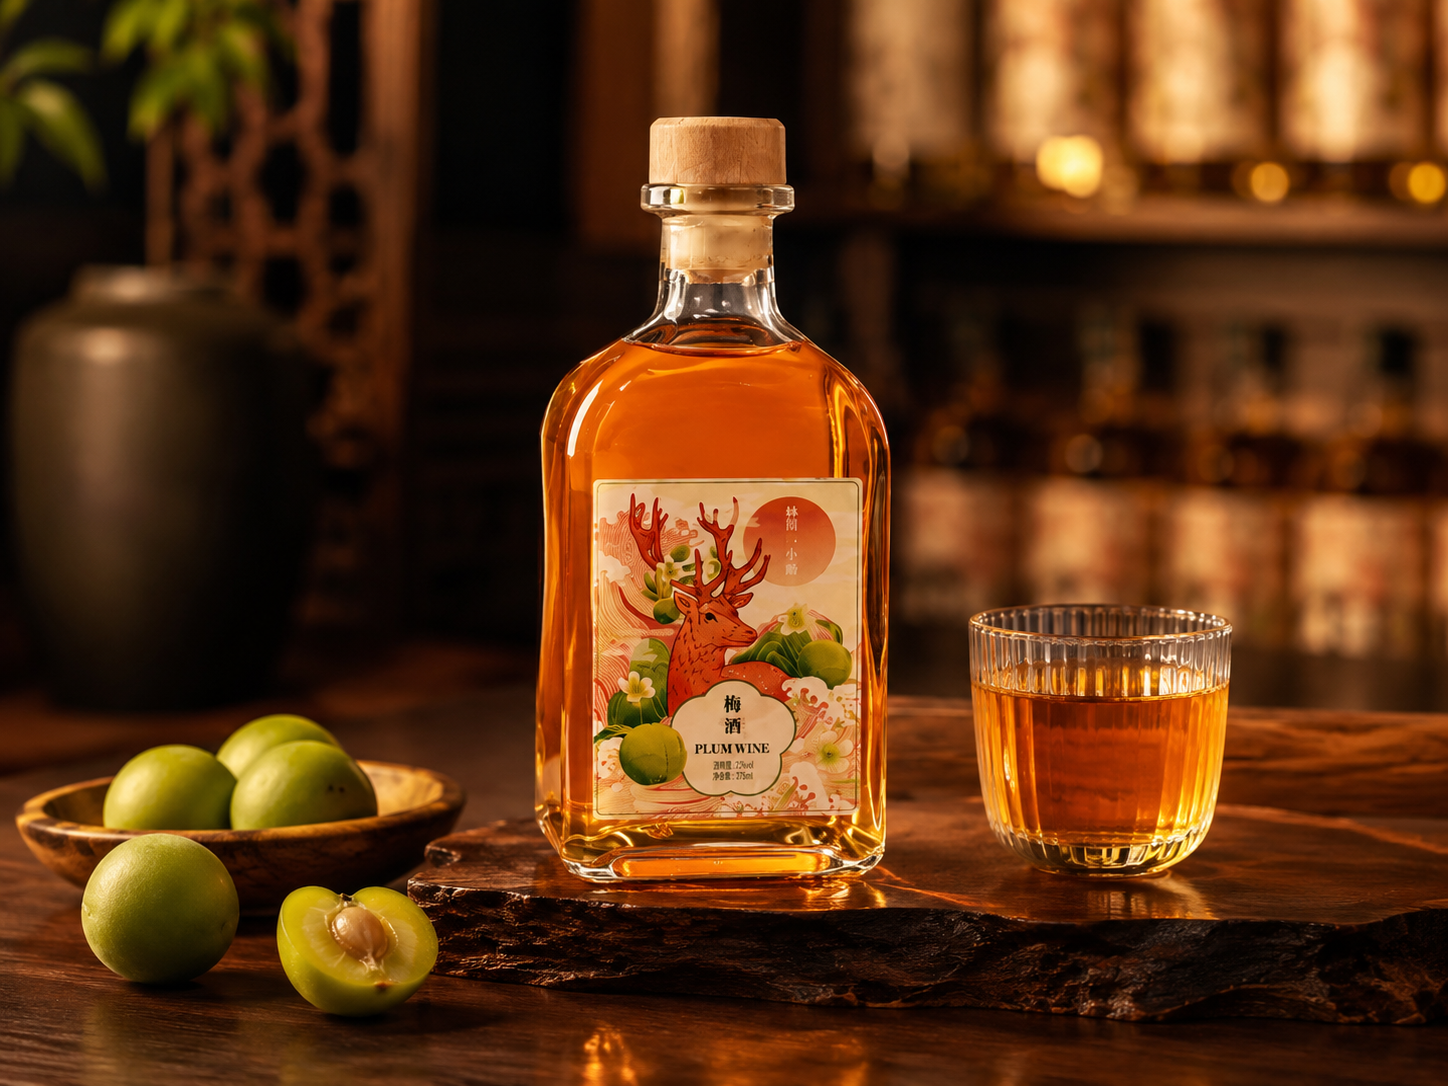
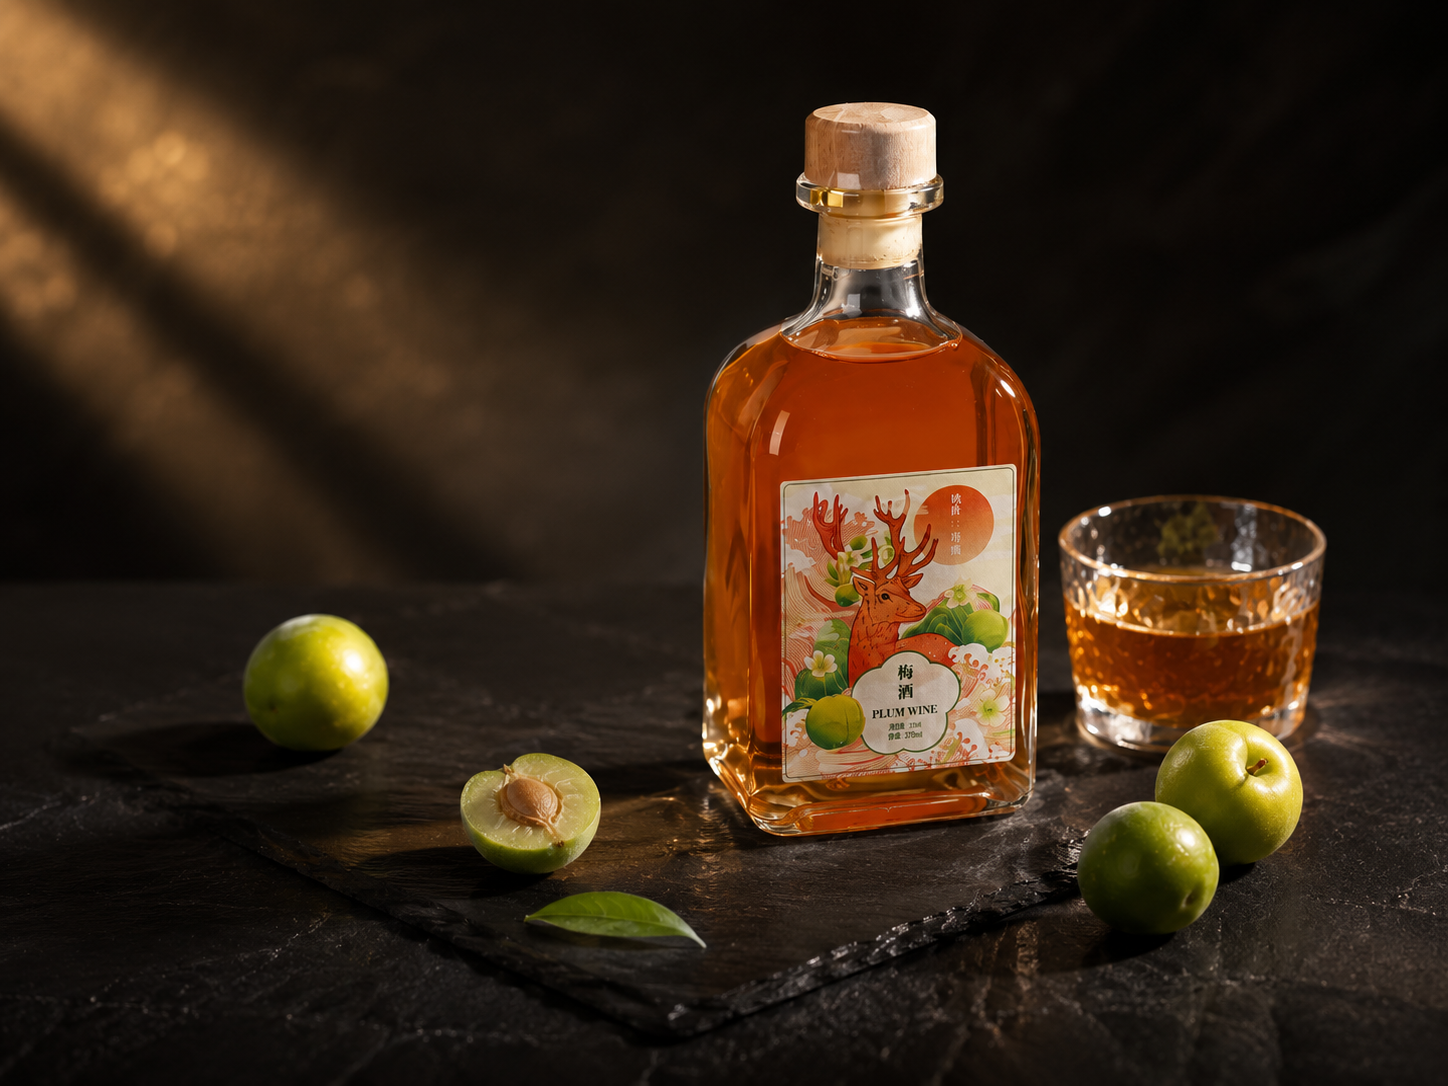
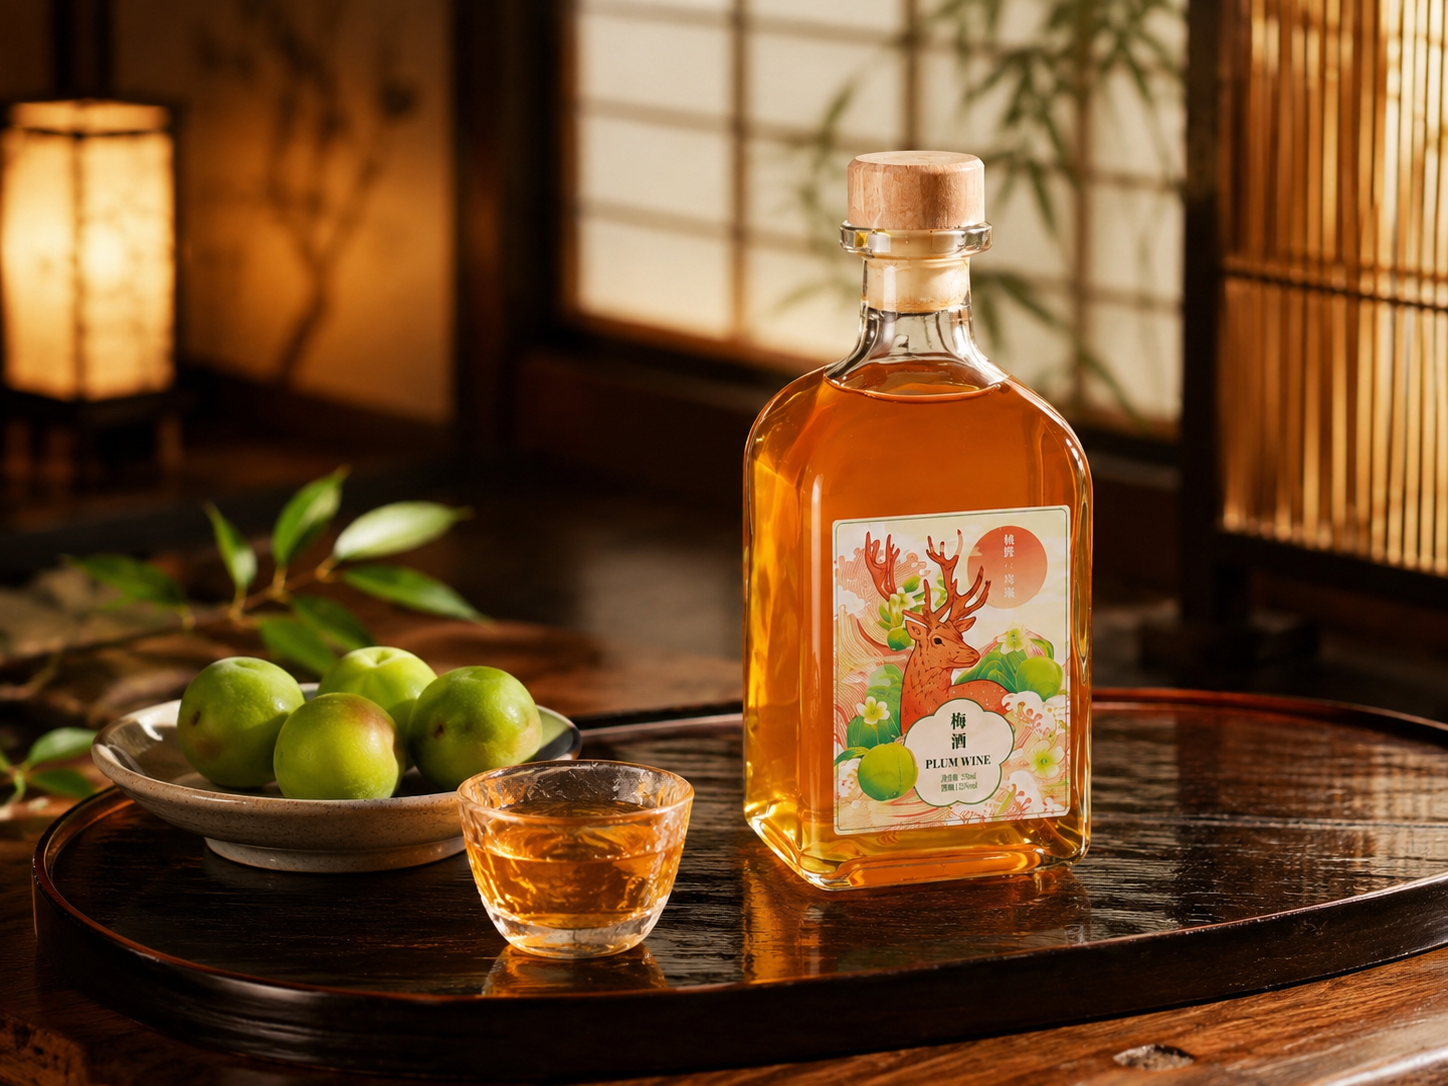
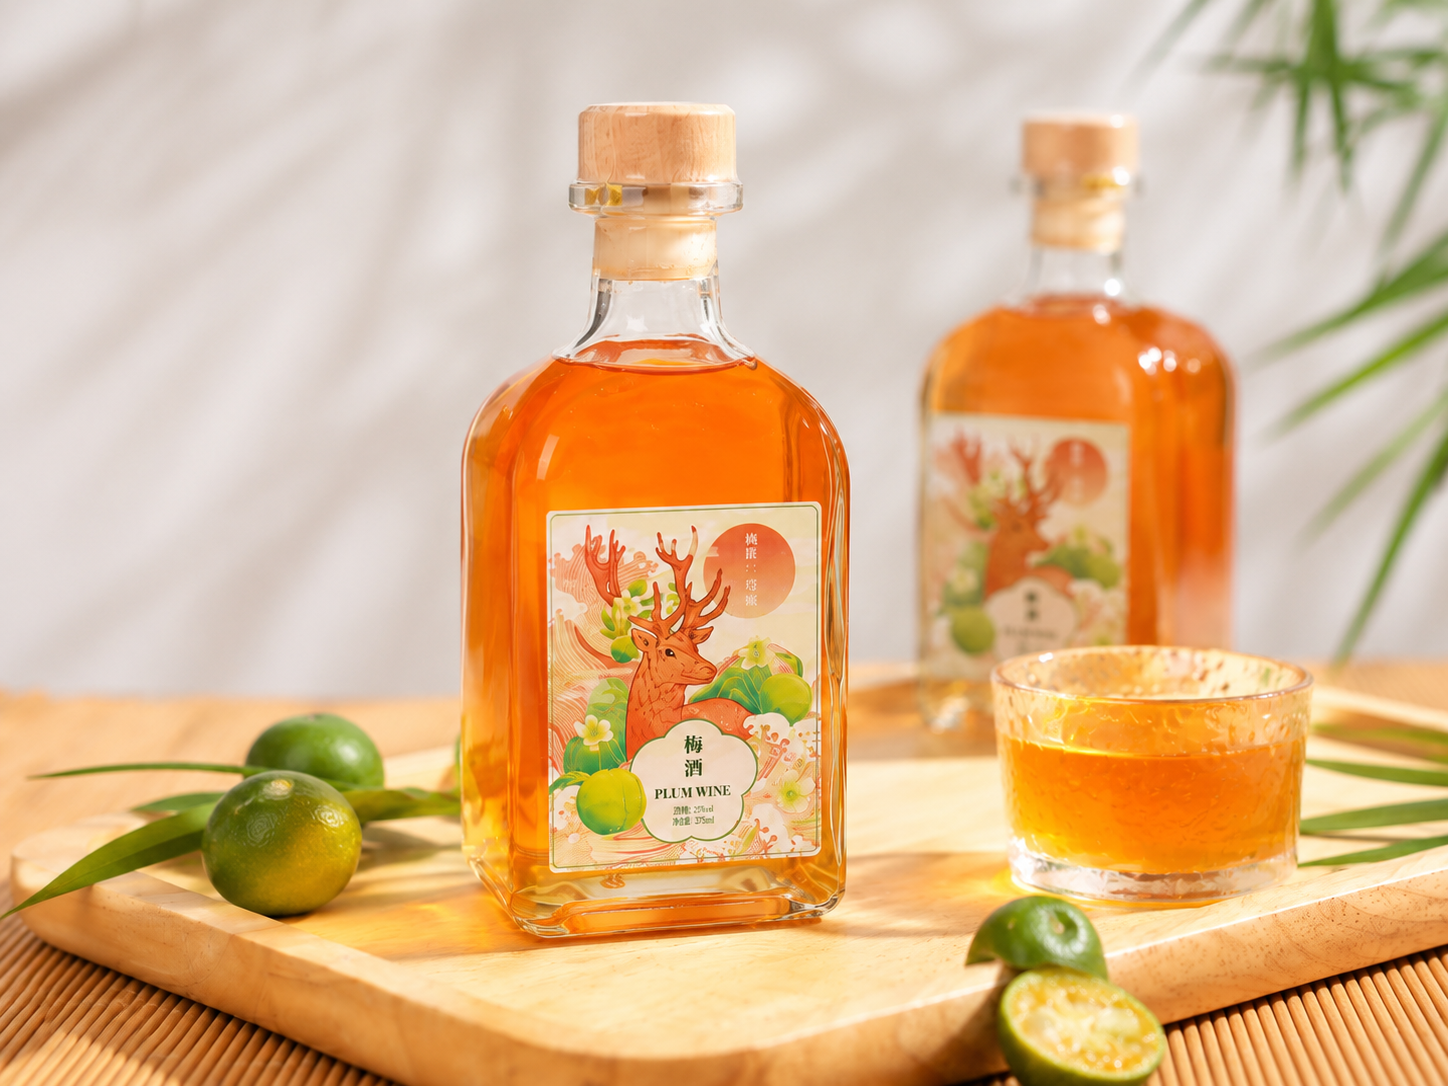
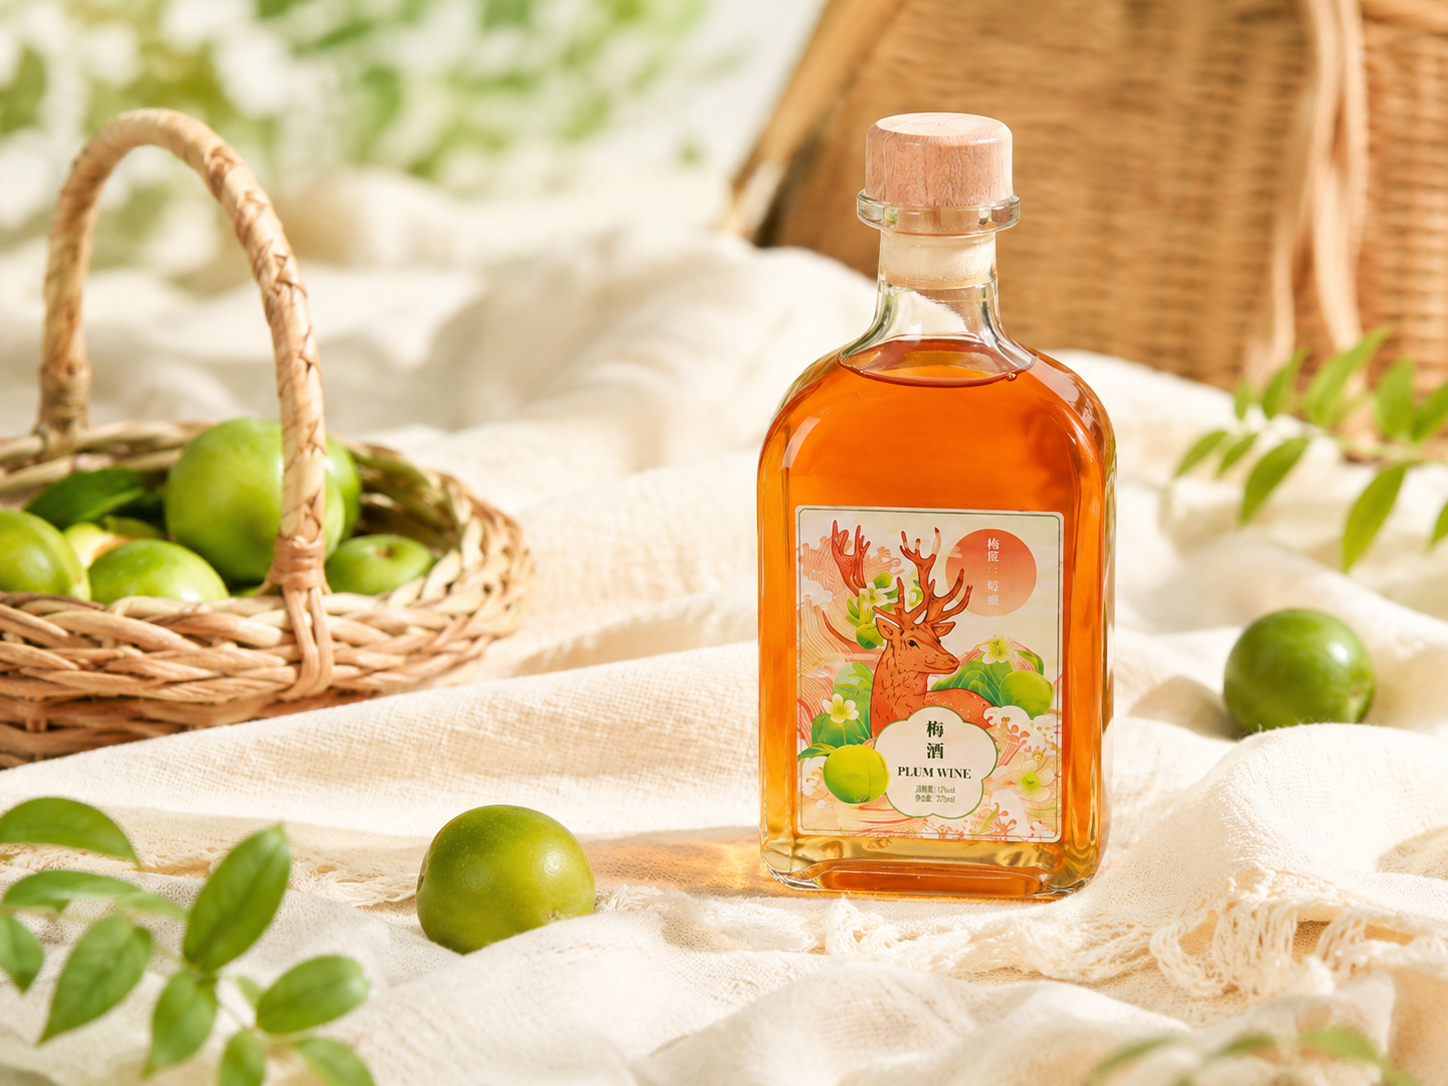
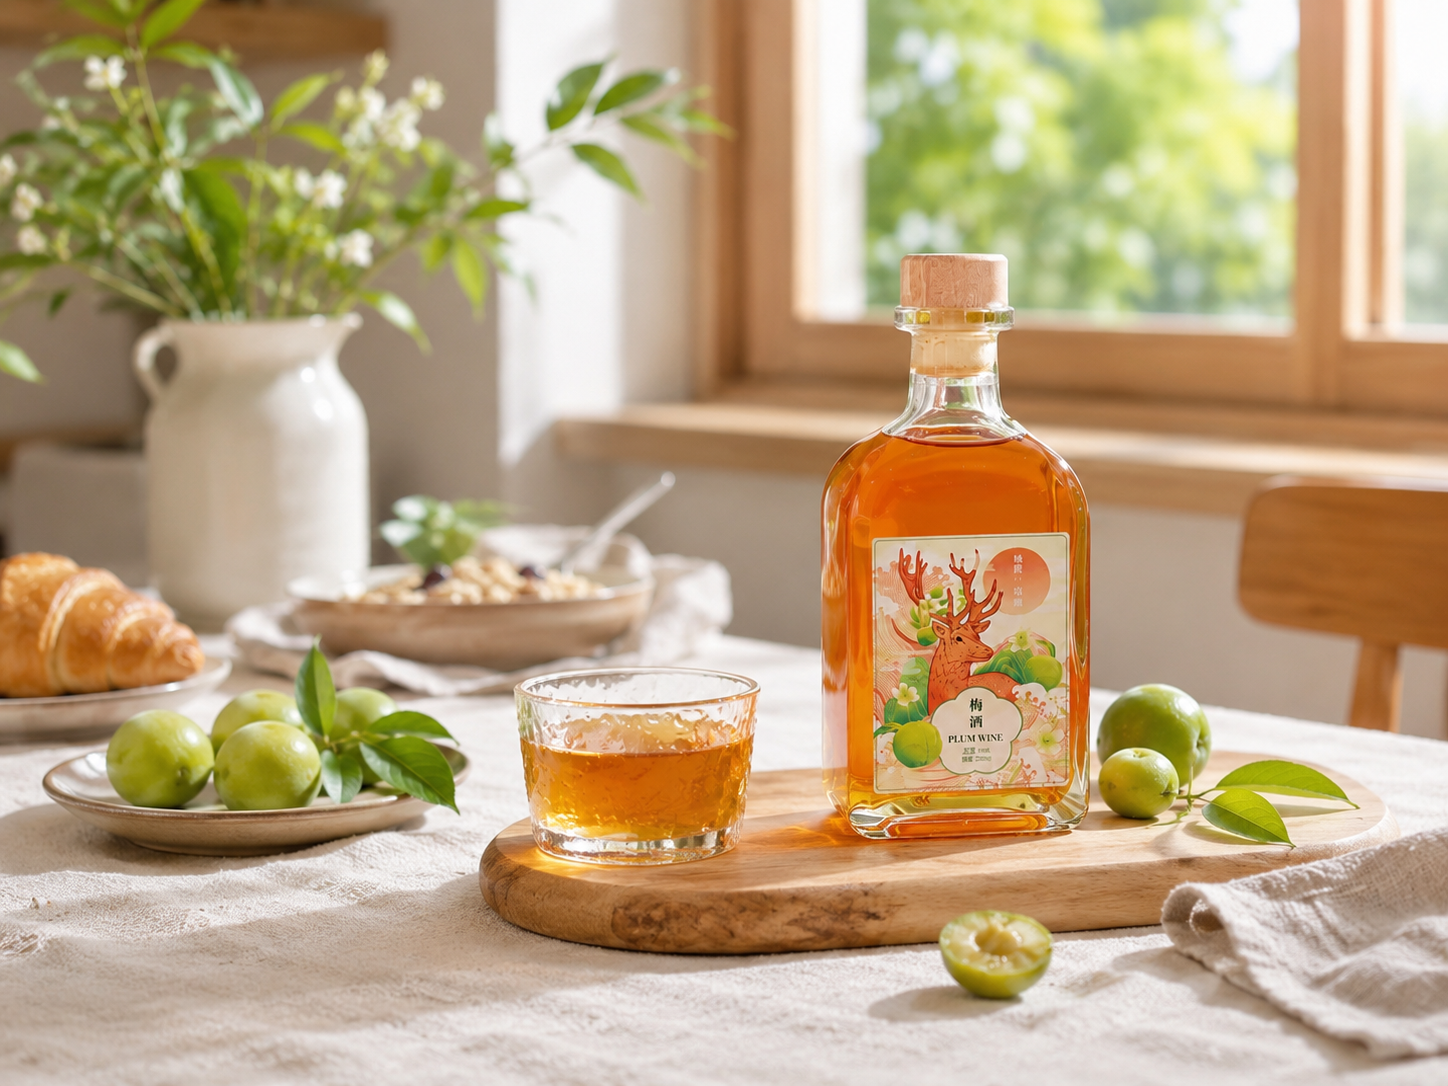
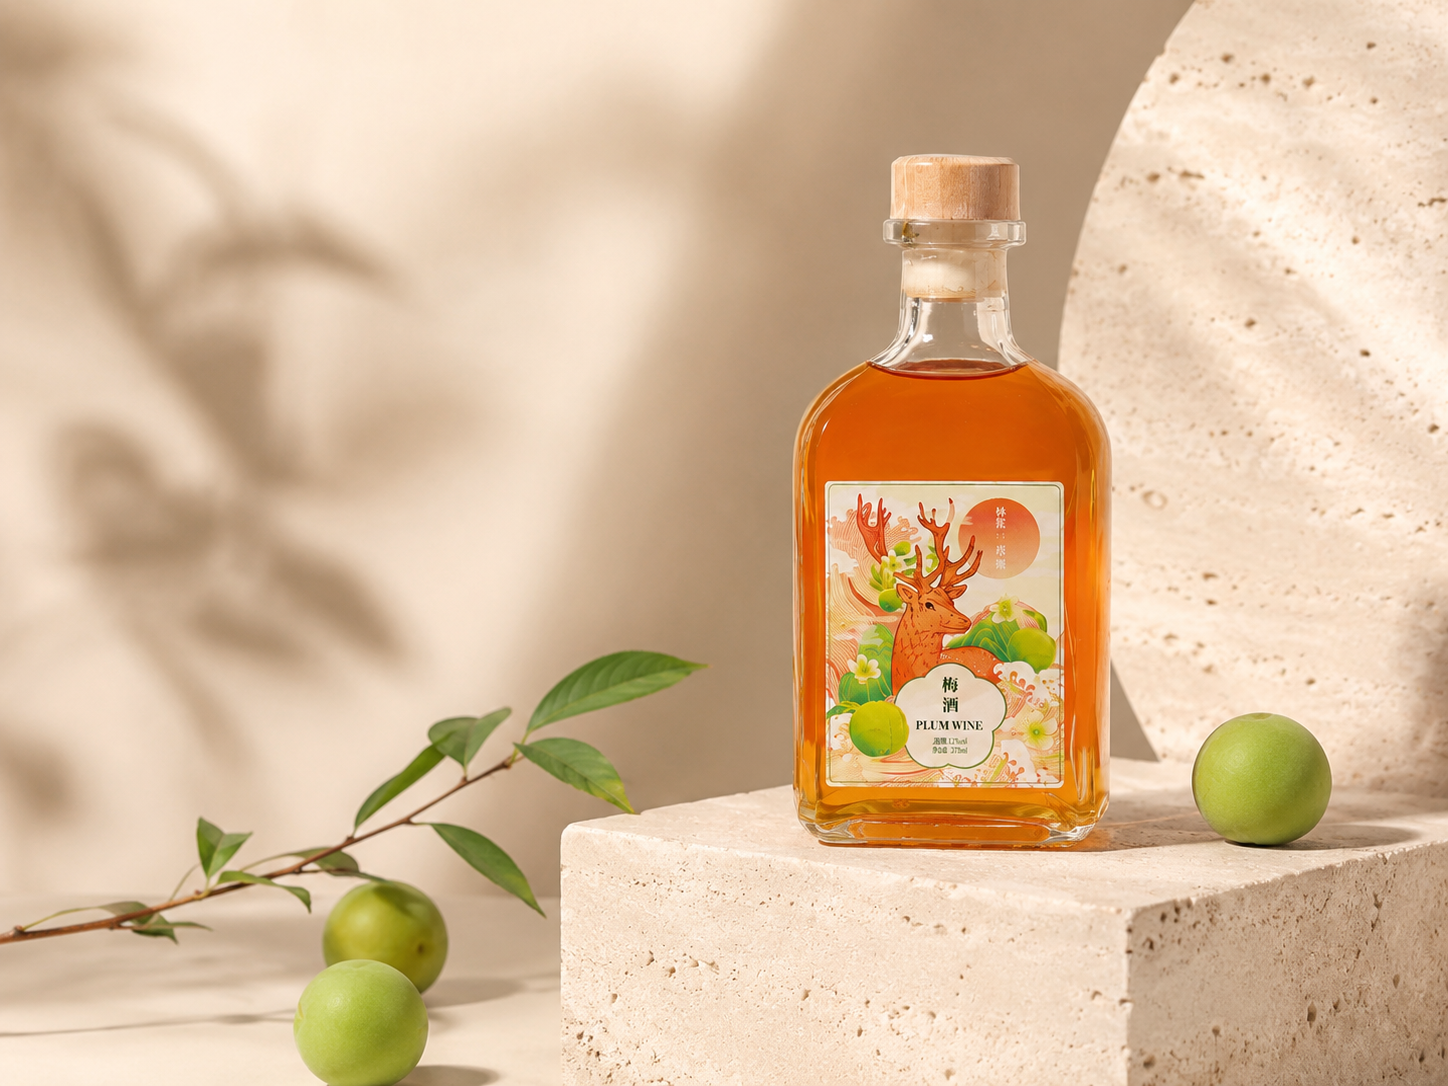
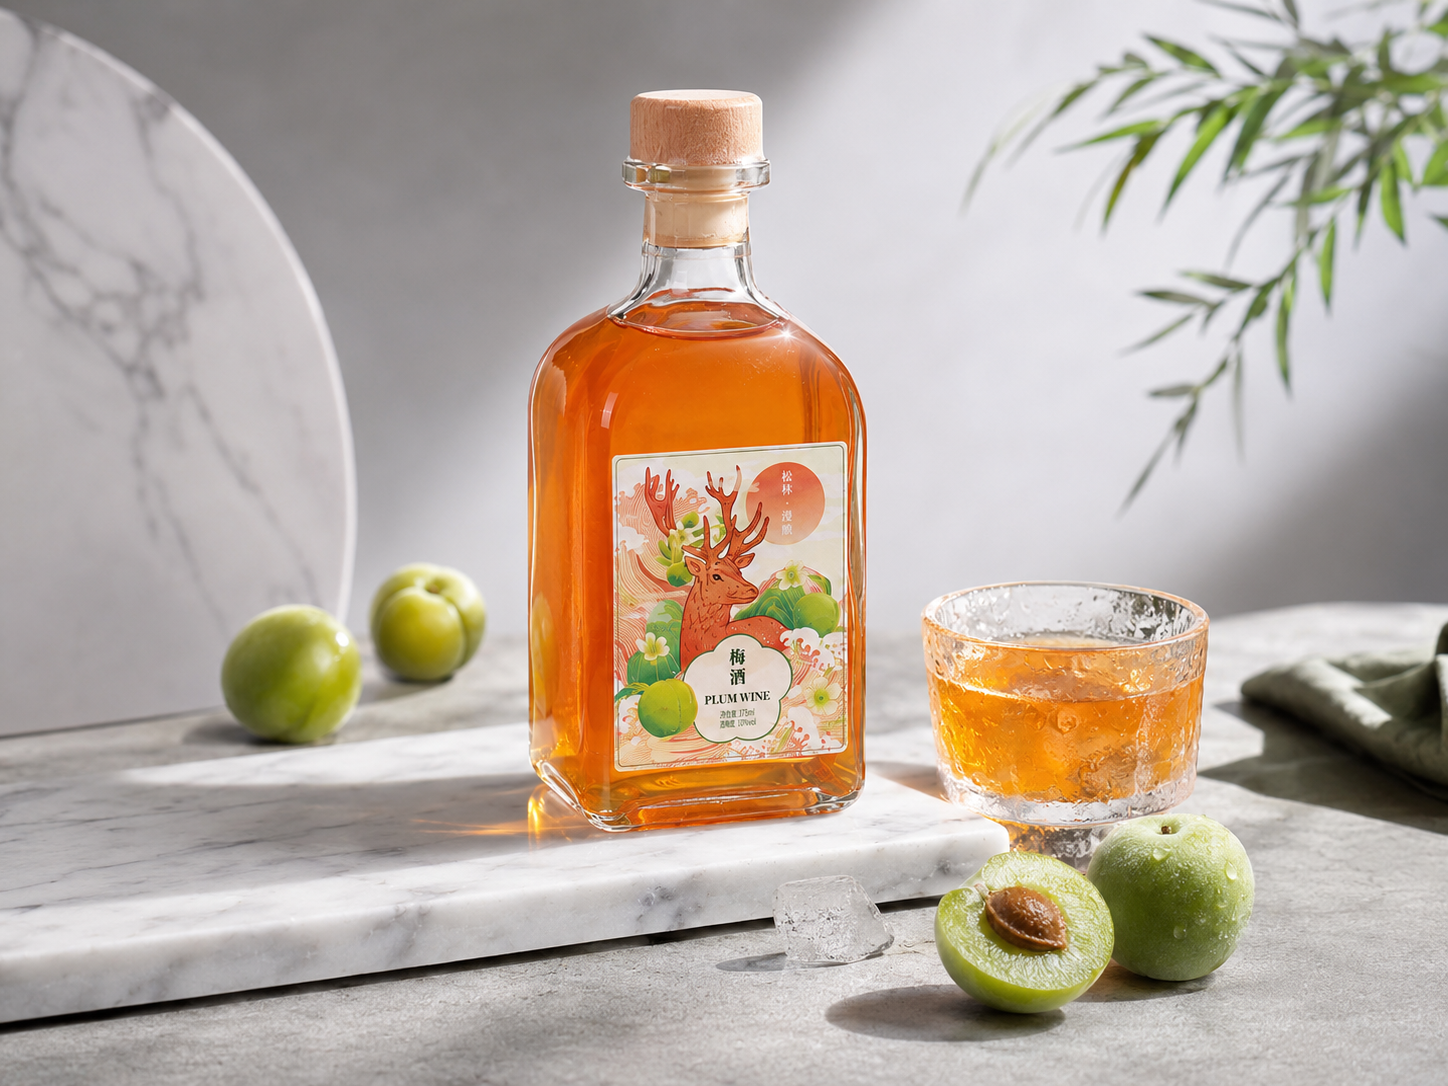
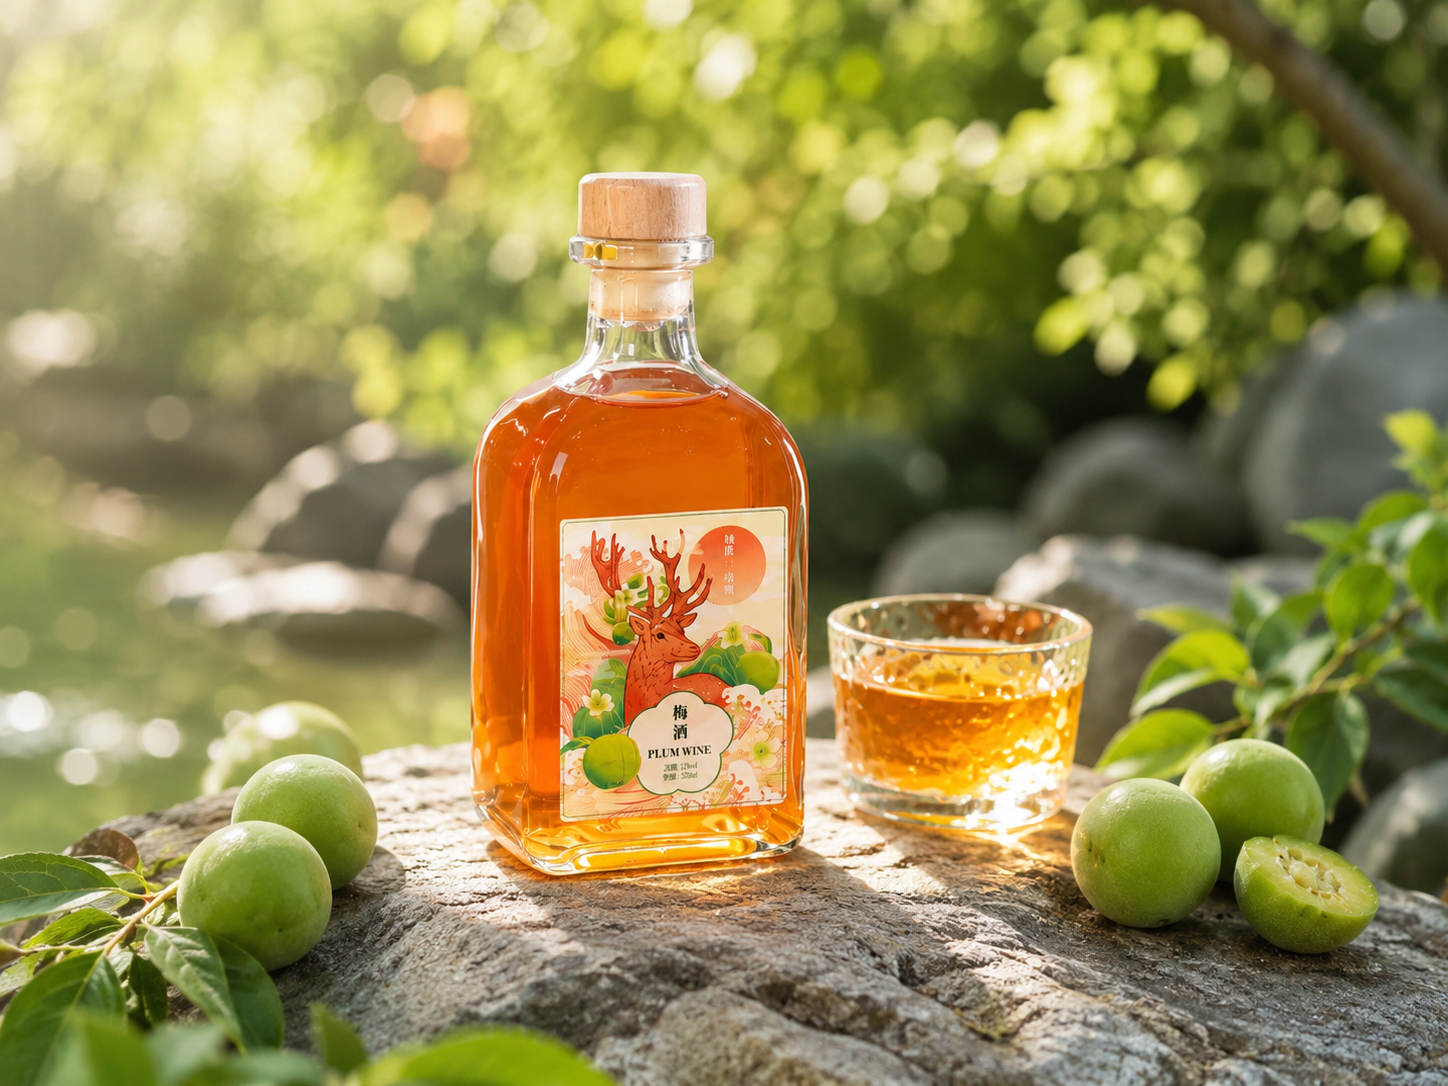
模板驱动
产品驱动
提升课程供给与分发效率
同质化严重
多个商品共用同一套背景模板("多品 1 图"),商家卖点和产品特征无法充分呈现。用户视觉疲劳,点击率下降。商品差异化优势丢失。
中小商家缺能力
大部分中小商家没有专业拍摄团队做产品包装,商品图质量参差不齐。缺少专业包装的商品图直接拉低转化率。
大促批量换图难
618、双 11 等活动需要大批量替换背景,传统人工套版效率跟不上节奏。营销节奏受限,错过最佳投放窗口。
02 / 核心难点
规模化生产中怎么同时保证商品真实、场景合理和风格可控
商品主图要服务销售转化,不能只看画面是否丰富。真正困难的是在大规模生成中,
同时保证商品形态正确、场景物理可信、比例真实和批量稳定。
难点 01
商品形态与轮廓复杂
输入商品涵盖方形、圆形、竖长、倾斜、裁切等多种形态,需分别制定背景生成策略与留白规范。商品轮廓越细碎,抠图残留与边缘失真越严重,良率随轮廓复杂度显著下降。
决定生成结果是否可用
难点 02
品类场景语义复杂
京东商品规模达数千万至上亿量级,3C 数码、家用电器、美妆护肤、食品酒饮等类目各自具备独立的场景语义——厨房小家电适配厨房场景,生鲜饮品适配户外自然,统一背景模板无法覆盖。
决定场景是否匹配
难点 03
品与背景的物理融合关系
商品置入场景后,其空间关系、比例关系与光影关系必须物理可信。典型失真:4cm U盘被参照物放大呈 20cm 视觉效果,1.8m 冰箱被环境比例压缩至 1m。任一维度失真,轻则视觉违和,重则构成虚假宣传。
决定产出能否上线
难点 04
规模生成的质量稳定性
2023 年图像模型能力有限,单张生成质量不代表批量产出稳定性。SKU 形态、品类与场景的组合空间庞大,需通过 ComfyUI 可控工作流保障批量输出质量,将 badcase 率控制在 <30%。
决定系统是否可持续运行
03 / 解法判断
把不确定性从模型转移到工程
图像模型能力有限——直接输入商品图和提示词,无法同时控制边缘质量、场景匹配、物理融合和批量稳定性。项目的核心判断:不让模型一步到位,在每个环节划清边界——模型只做能做的,其余交给规则和工程。
判断 01
可控链路替代整图重绘
模型无法一步到位完成换背景。将生成拆为抠图 → 背景生成 → 产品原样叠回 → 光影修饰的可控链路——产品本体像素级保留,模型只负责背景区域,从架构上规避边缘失真与比例失真。
判断 02
数据归纳场景方向
场景拆解不依赖设计师经验分类。按一级类目×三级类目×点销排名交叉筛选高价值 SKU,从其真实背景中归纳可训练的场景方向——这是统计学问题,不是审美问题。
判断 03
设计判断转译为标注语料
不给参考图让算法自行理解,而是将空间关系、比例关系、光影方向等设计判断结构化为算法可执行的训练语料,确保物理融合要求进入模型训练过程。
判断 04
生成参数固化为标准配置
百万级月产量要求生成过程标准化。参数固化为可复用配置,不逐张调优,以工程手段保障批量输出的质量稳定性。
04 / 商品背景图生成
从商品形态到场景背景的批量生成能力
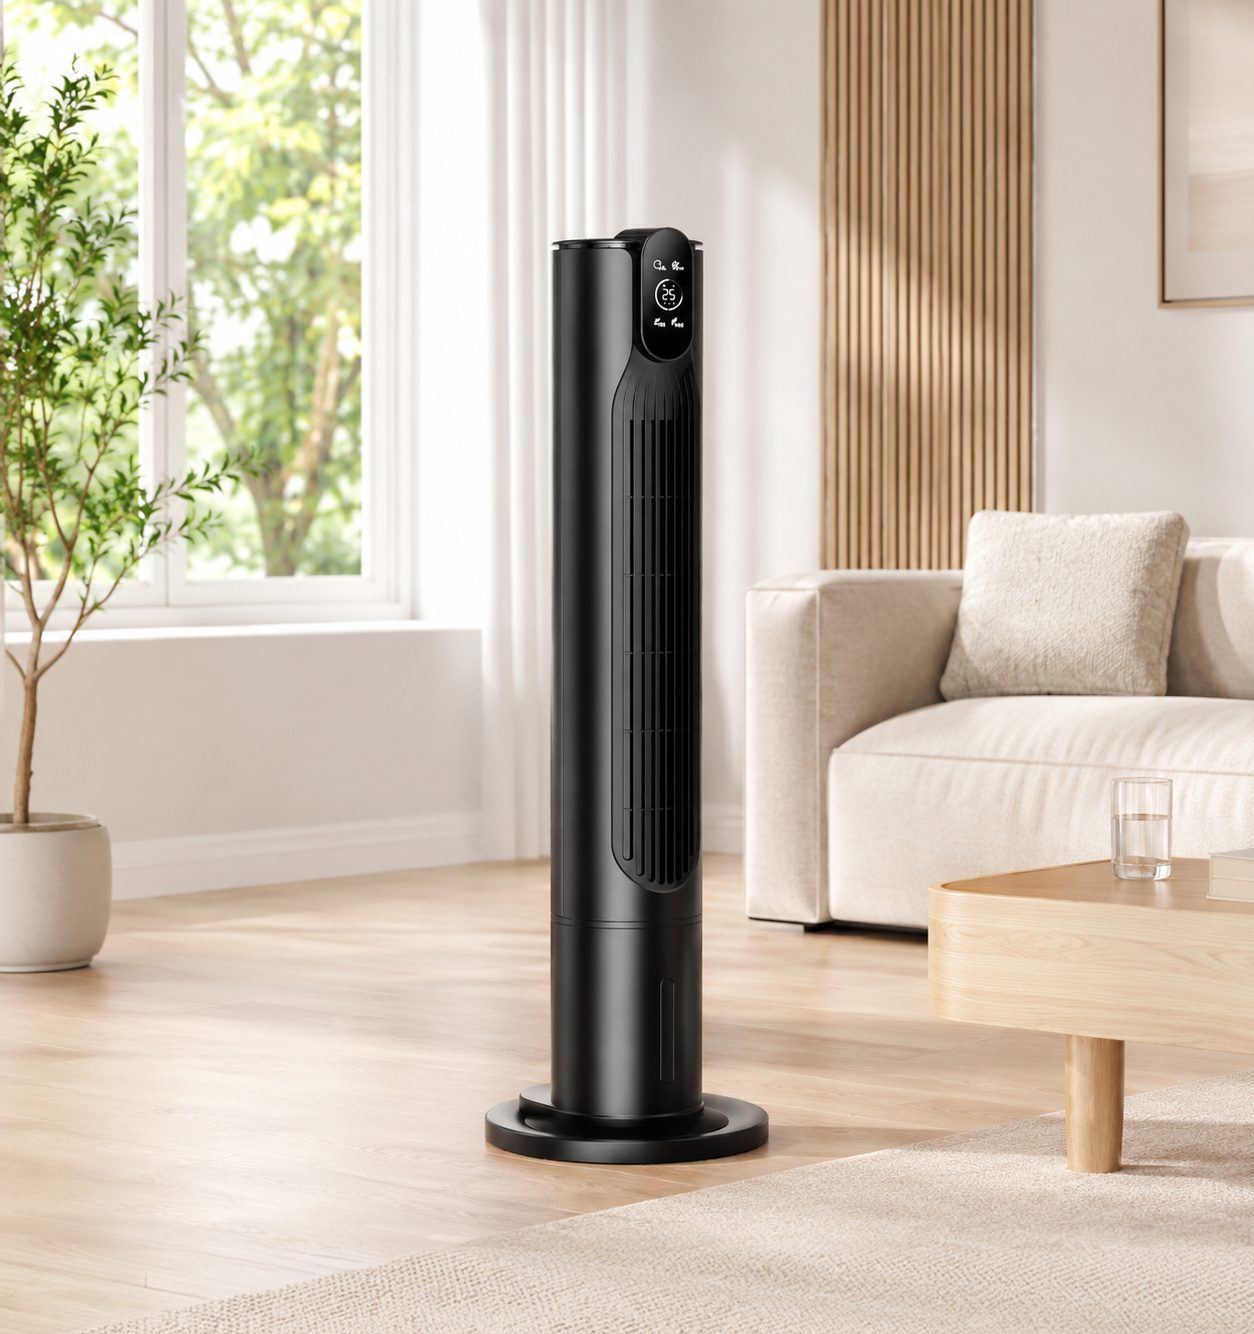
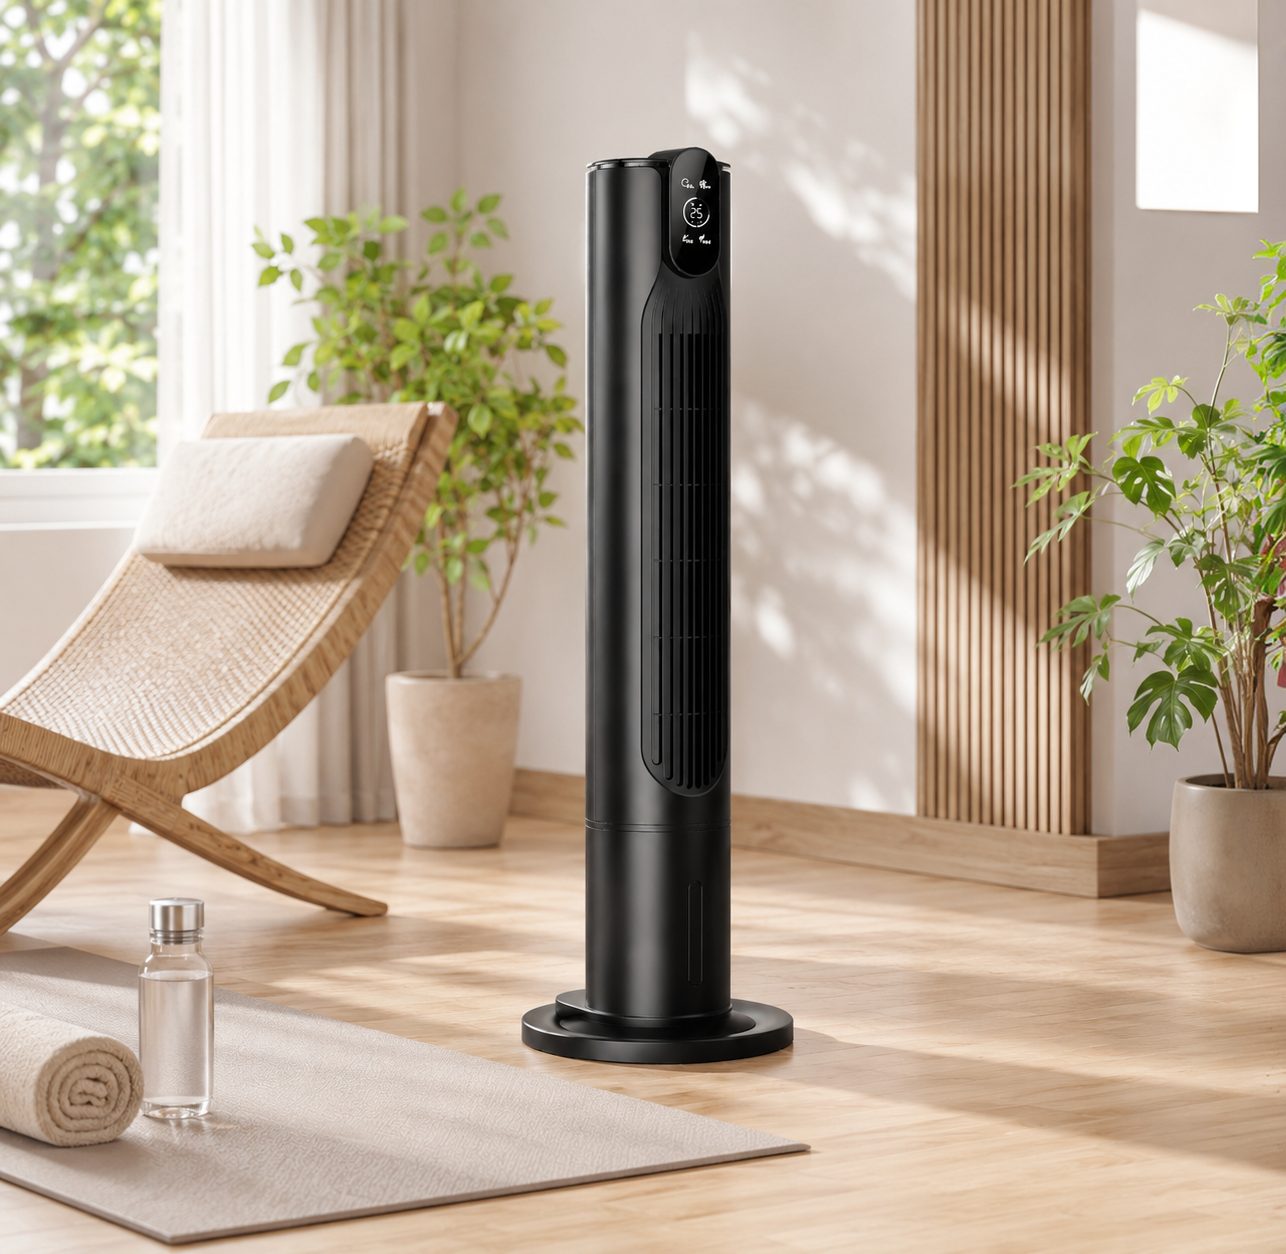
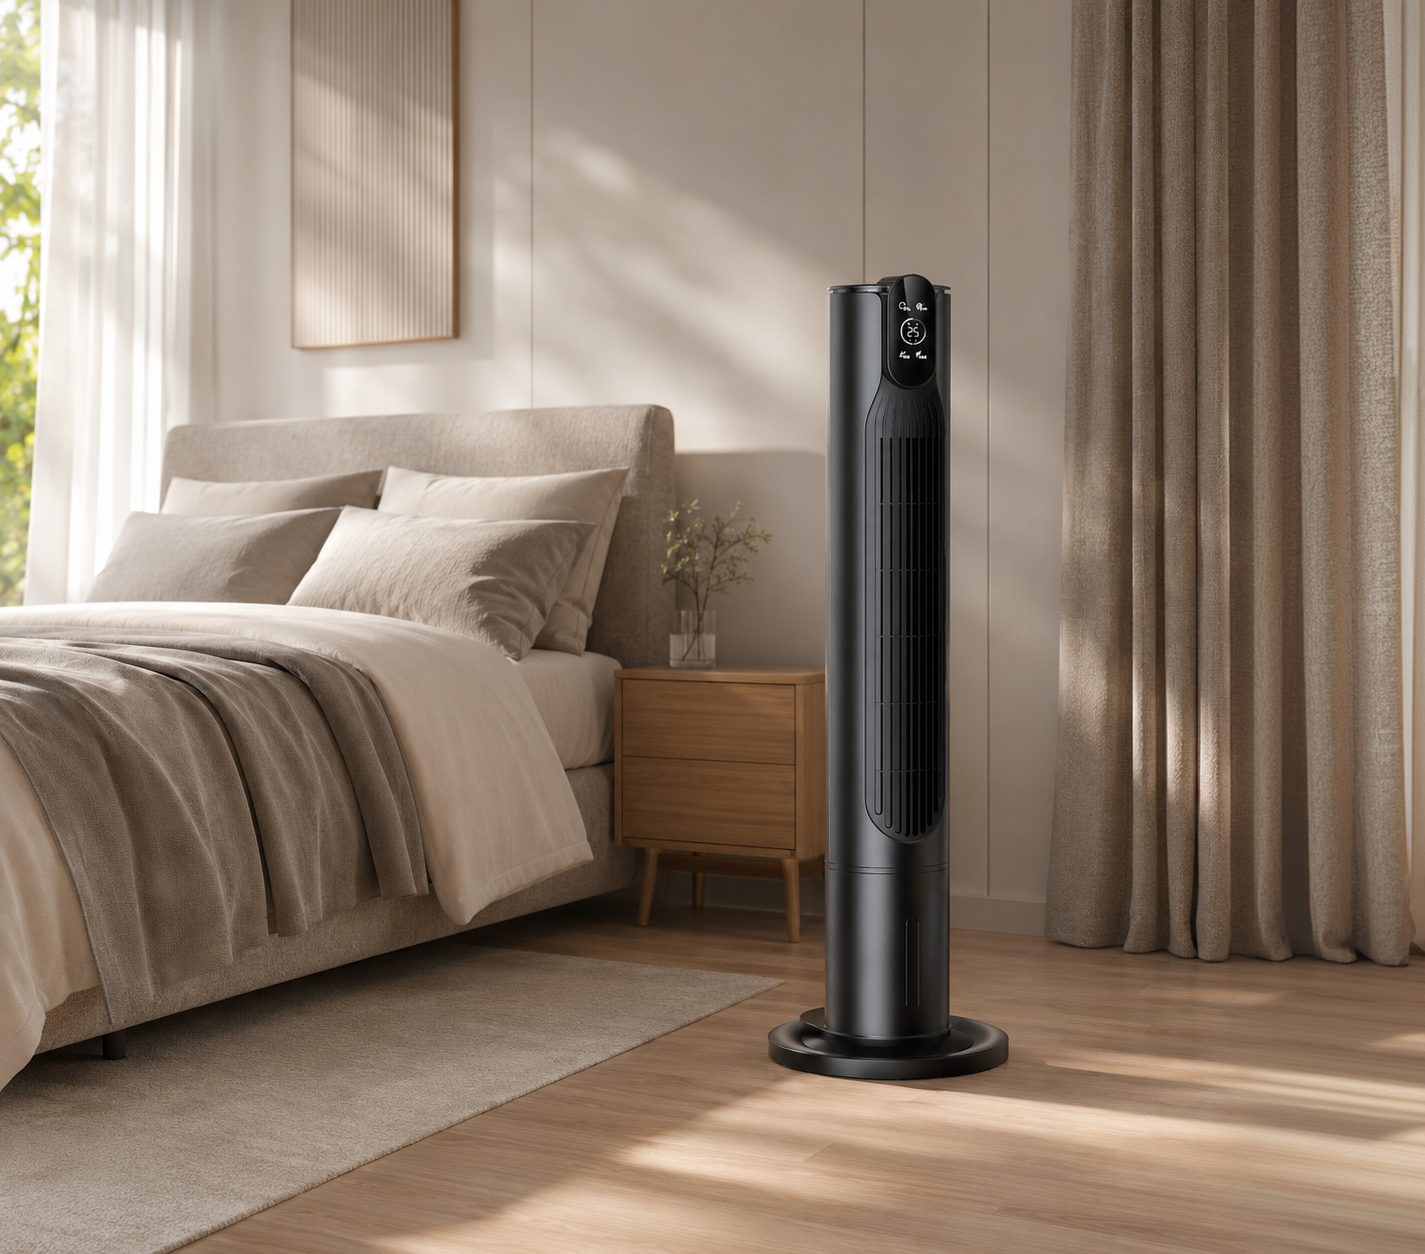
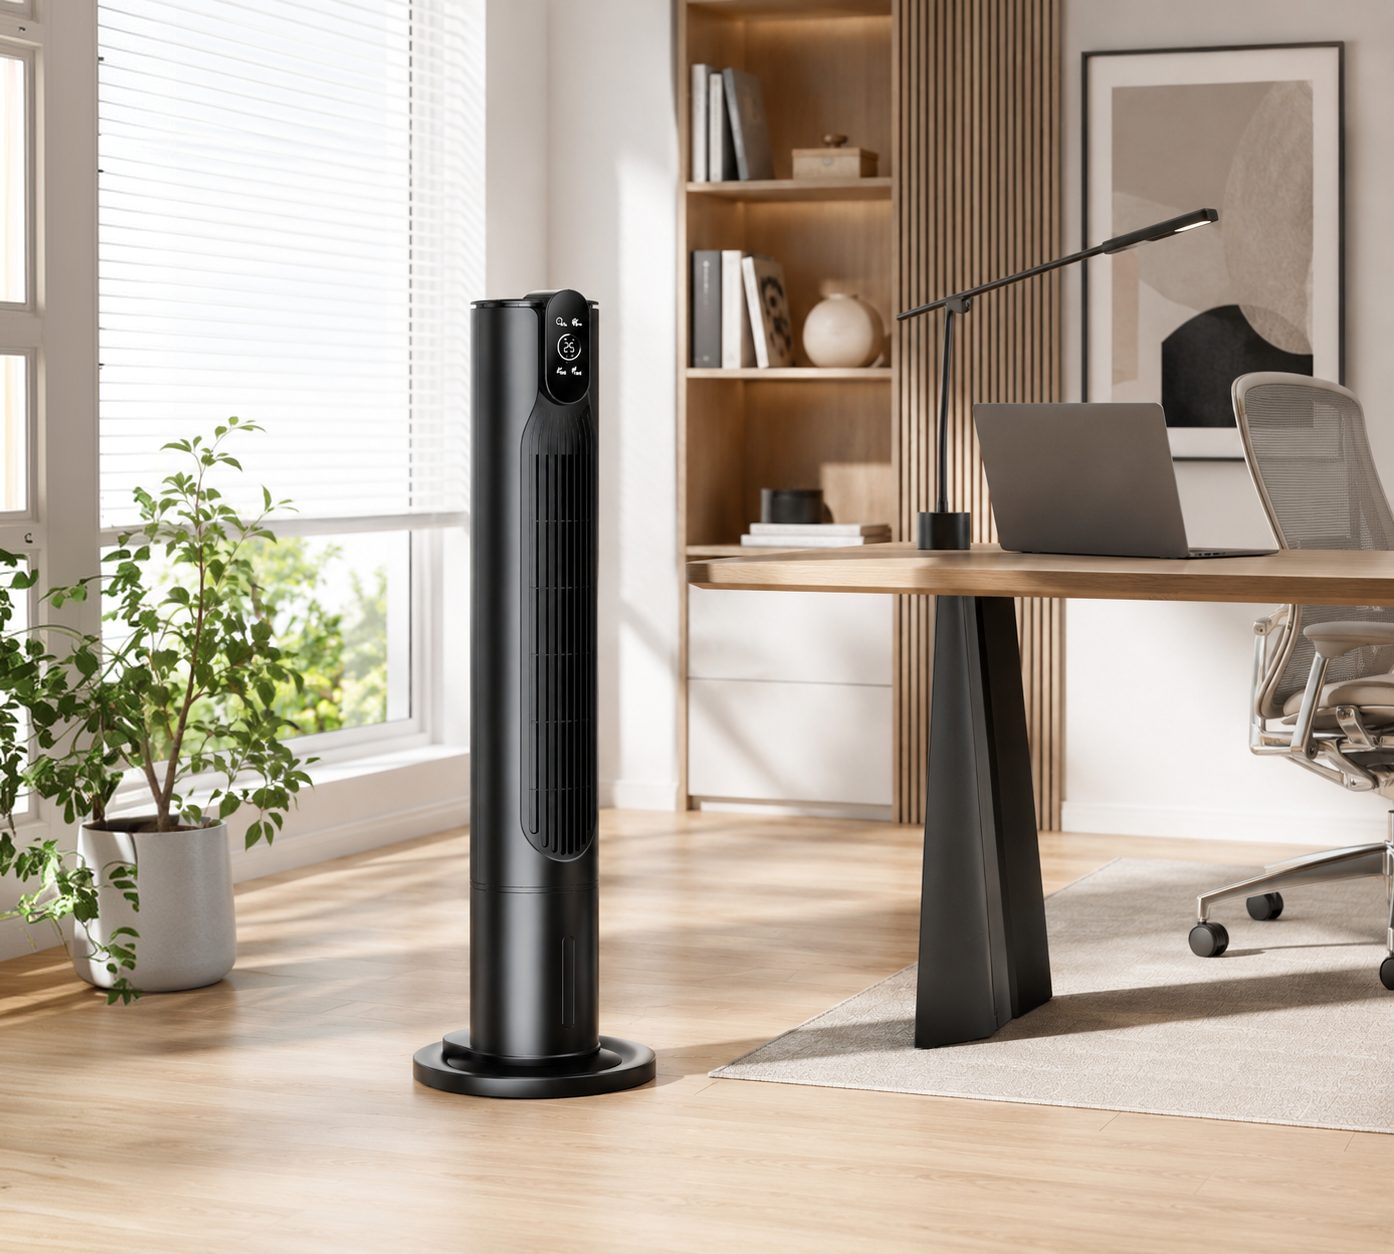
解决核心问题:输入一张白底商品图,输出一张场景融合、可直接投放的背景图。围绕这条链路,依次完成安全区域规范、场景方向收敛、定向模型训练与可控生成工作流搭建,每个环节的产出作为下一环节的输入。

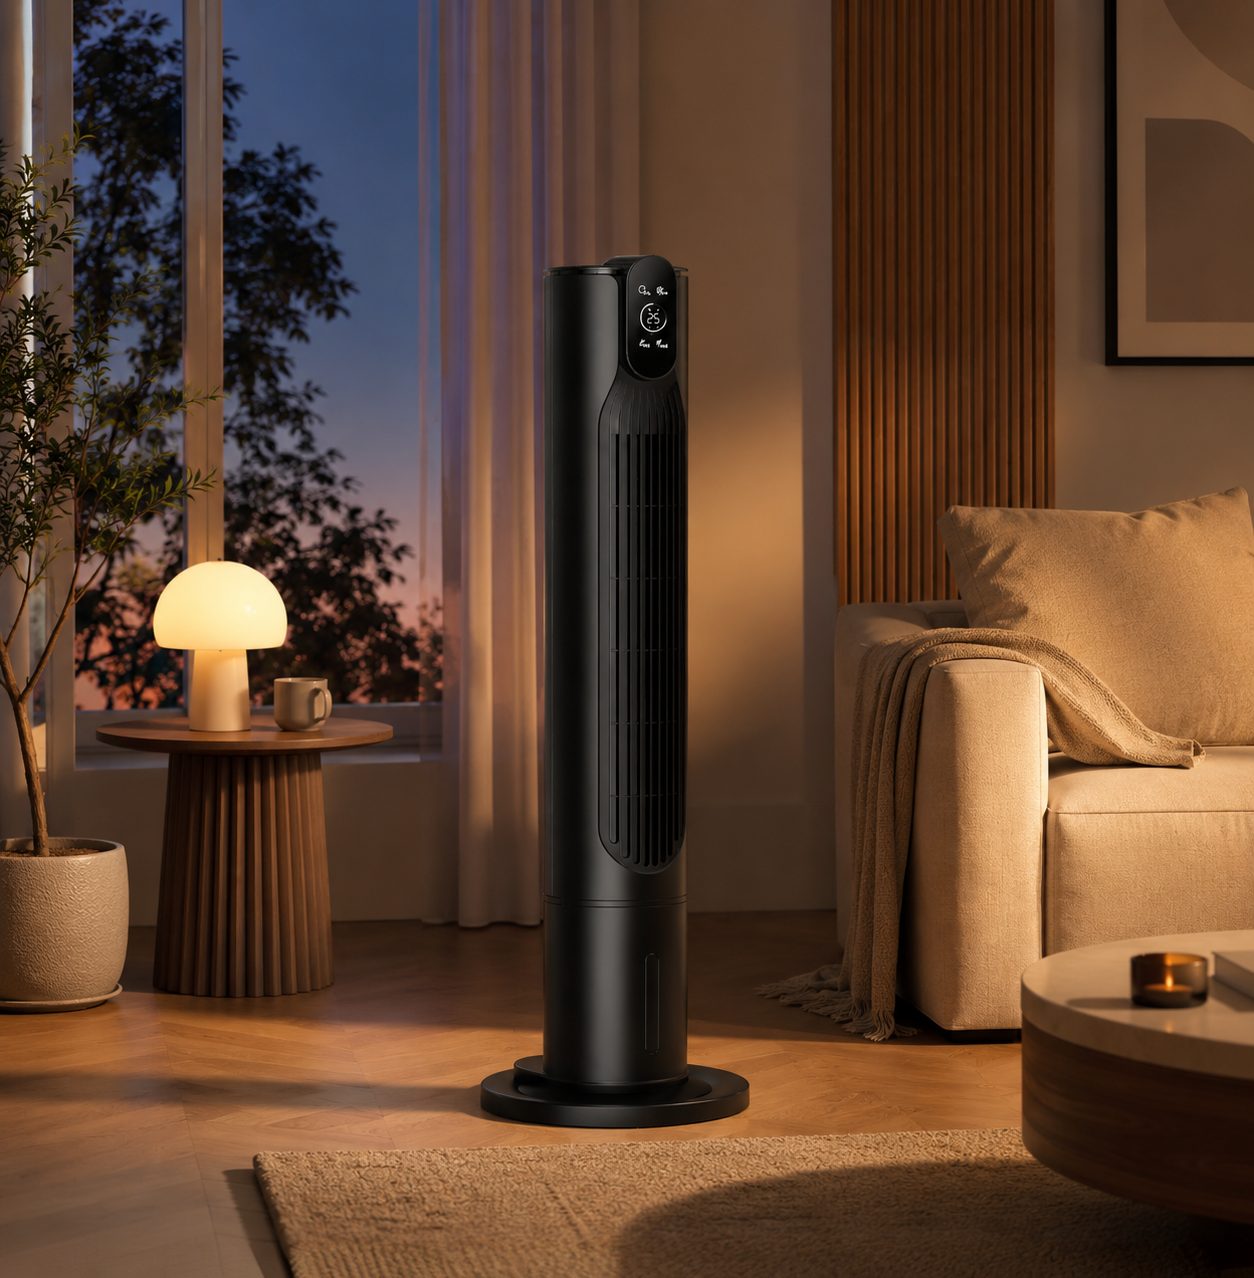
安全区域规范
识别 SKU 原始图的外形、占比、视角和裁切方式,为每种形态制定安全区域与留白规范——确保后续叠加文案和标签时不会遮挡商品主体。
创意归因与场景结构
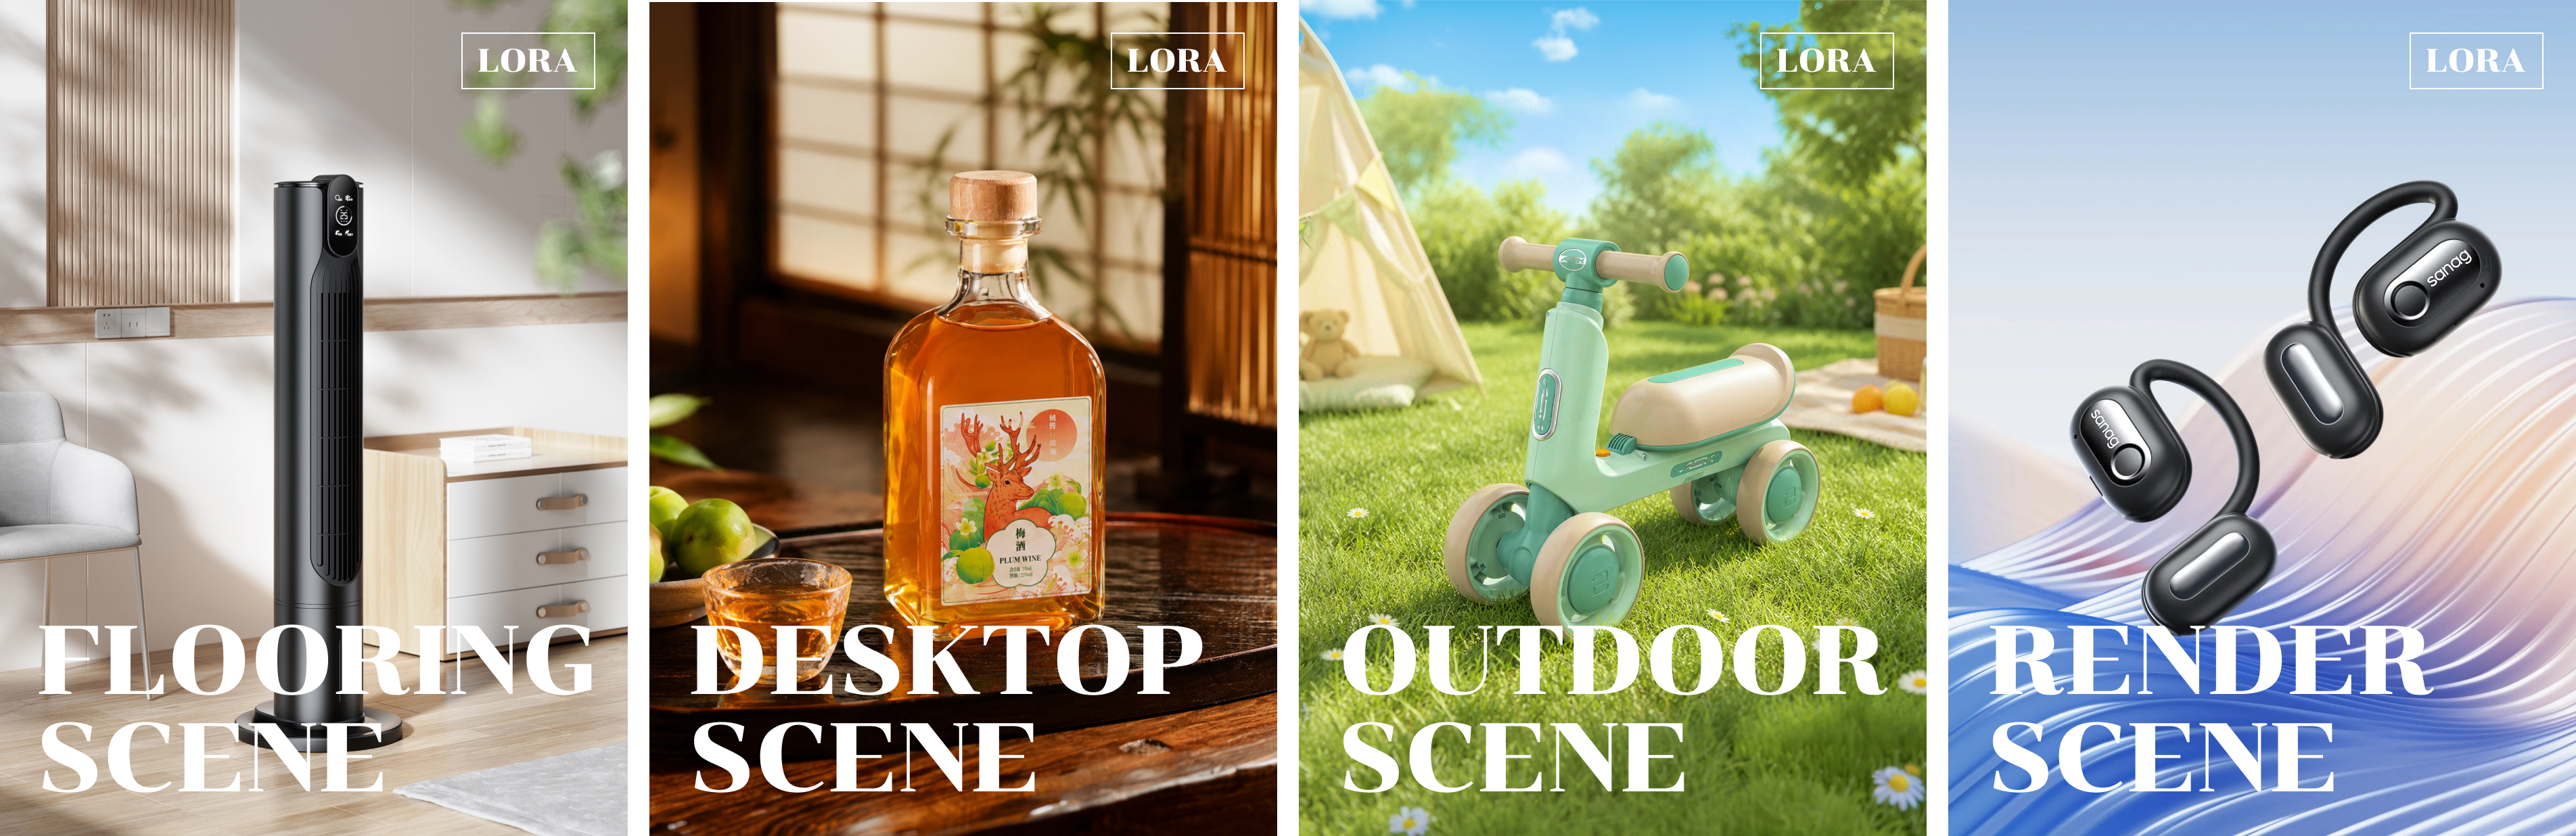
从一级类目×三级类目×点销排名交叉筛选高价值 SKU,采集其真实背景图做特征分析,归纳出可训练、可归类、可复用的场景方向——每个场景方向对应一个 LoRA 训练目标。
类目
样本收集
场景聚类
LoRa
3C
数码
电脑
办公
家用
电器
美妆
护肤
食品
酒饮
点消
排名
场景
解构
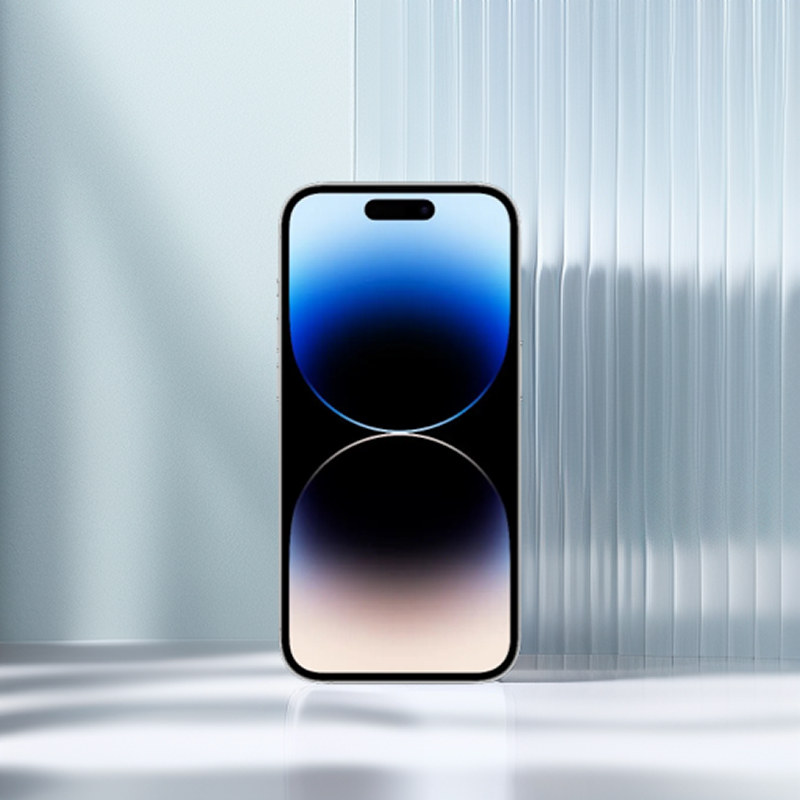
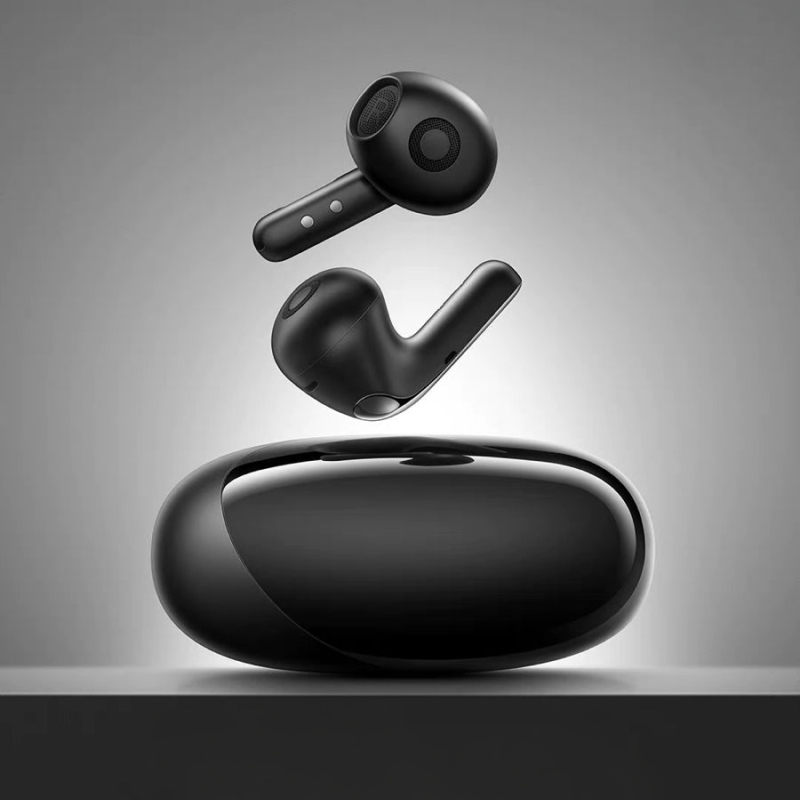
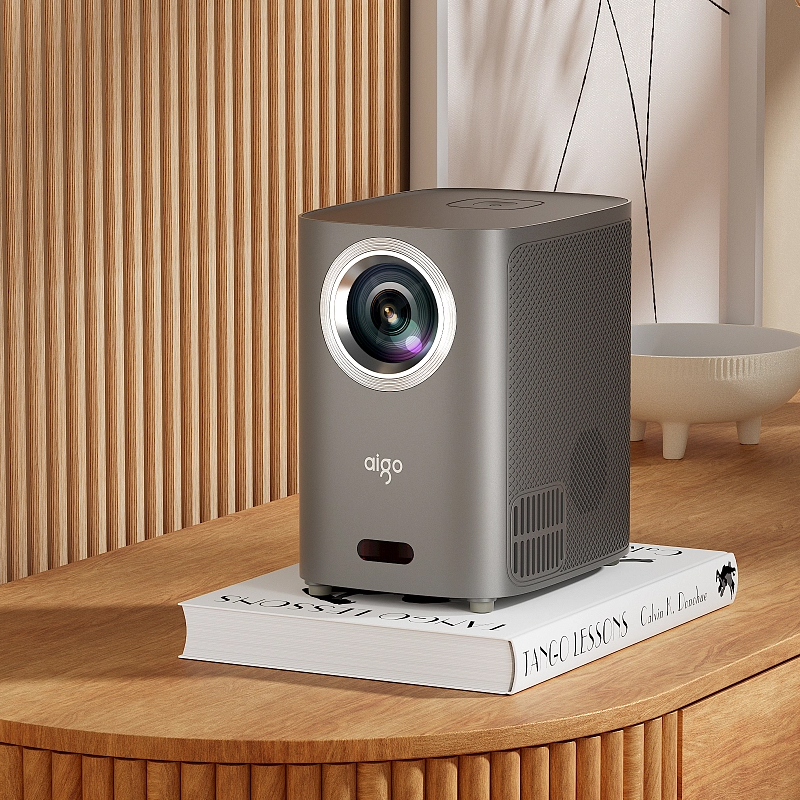
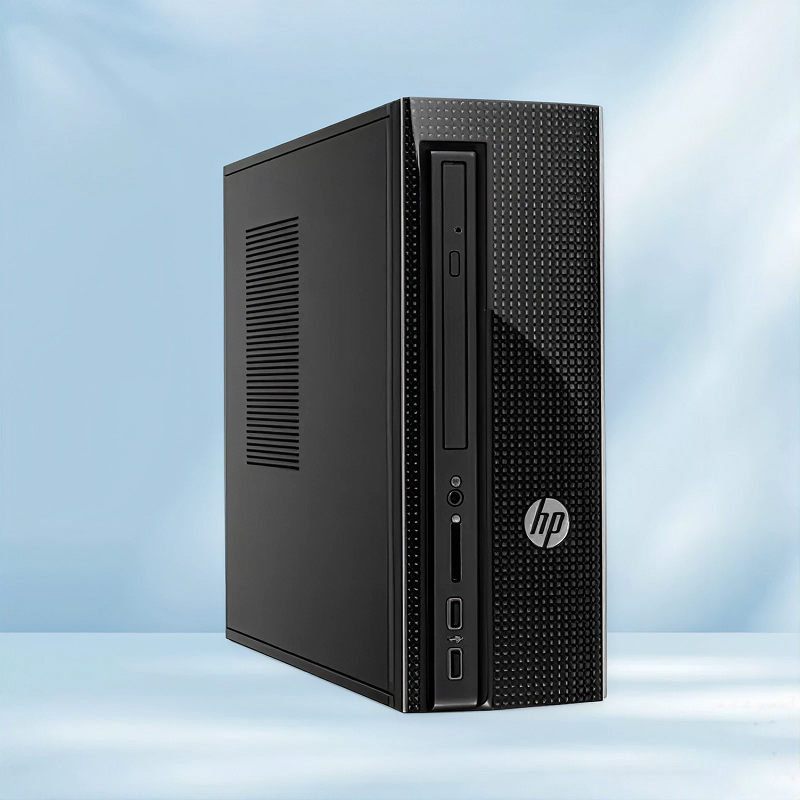
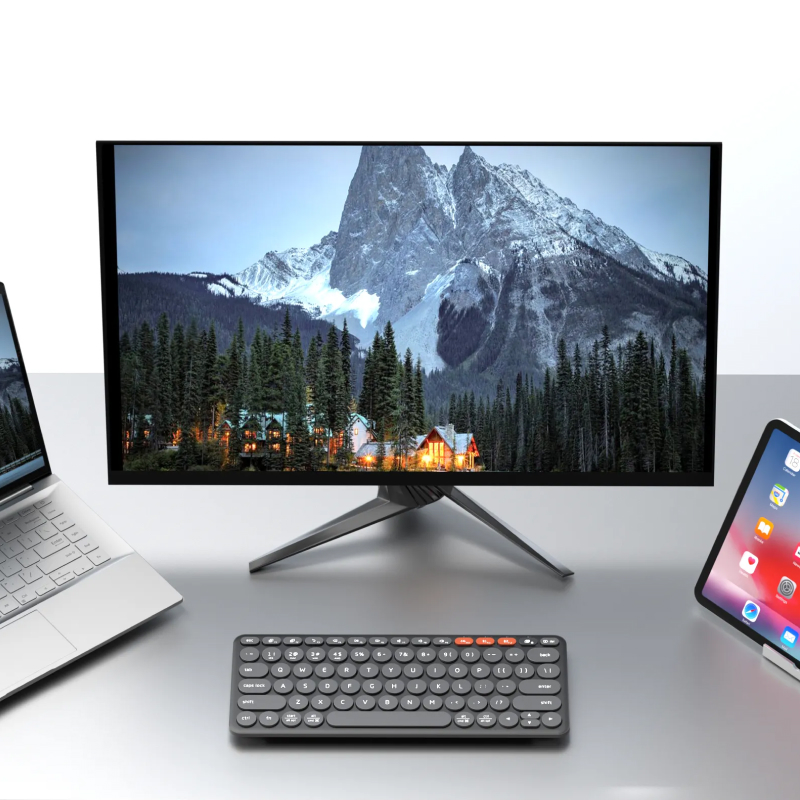
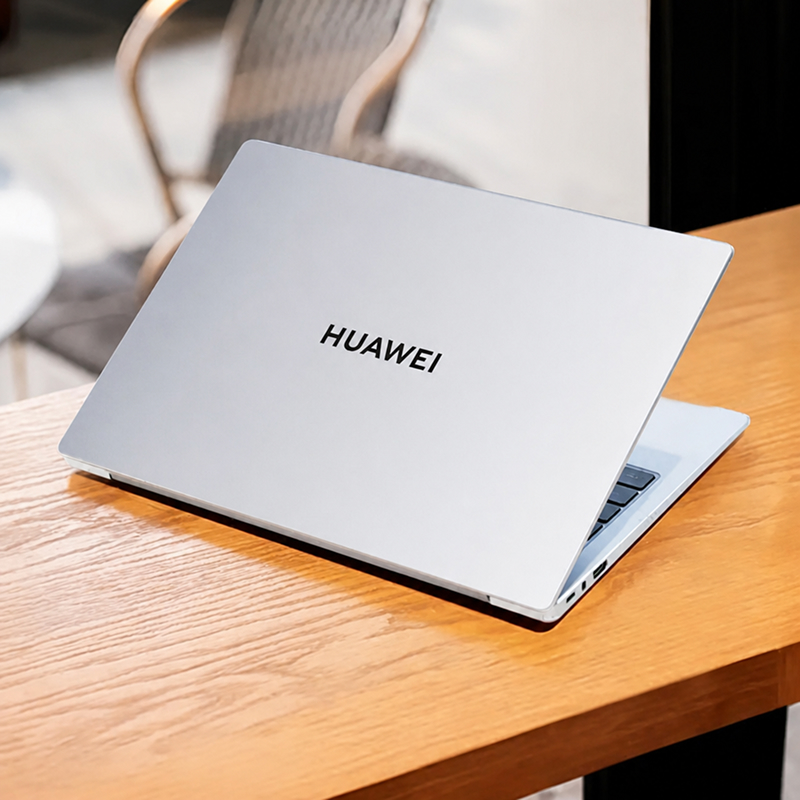
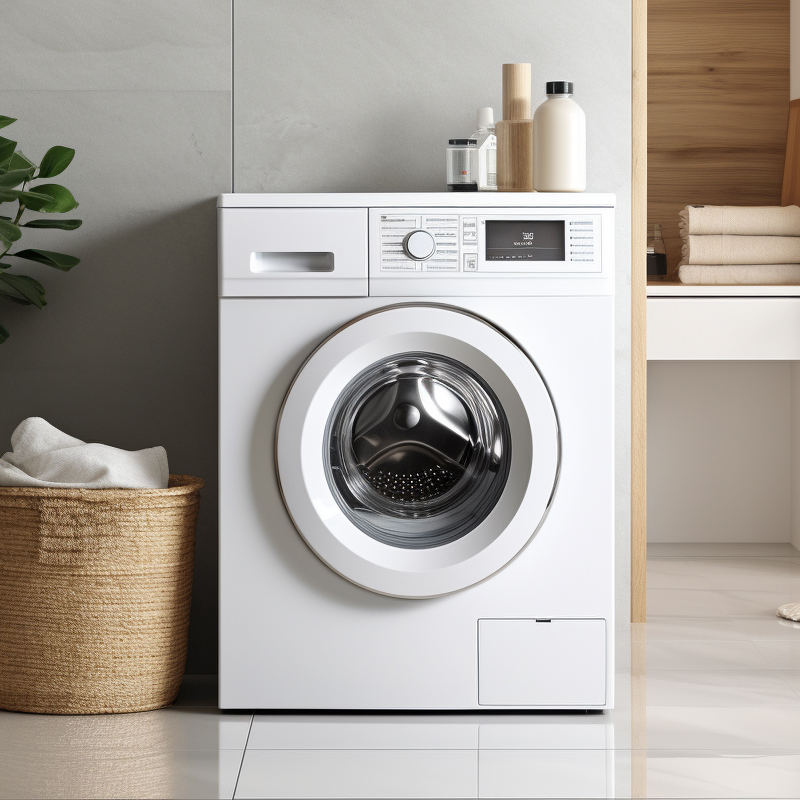
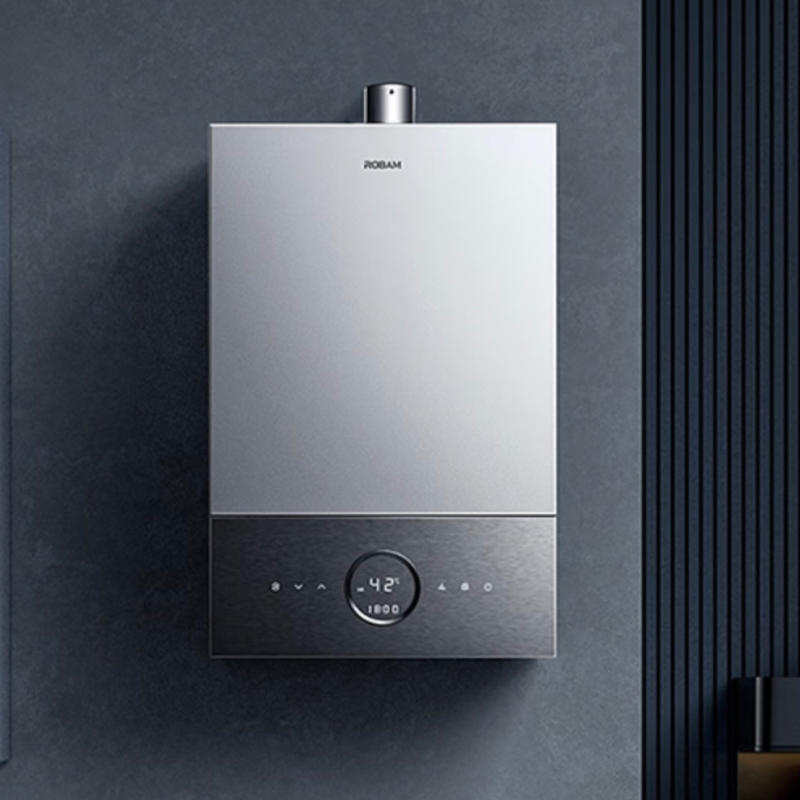
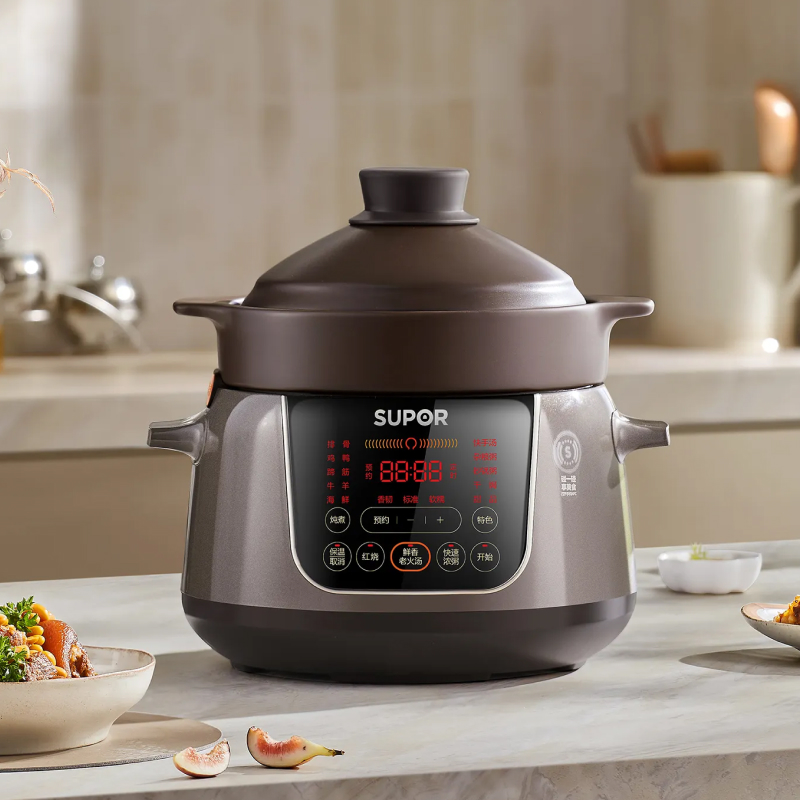
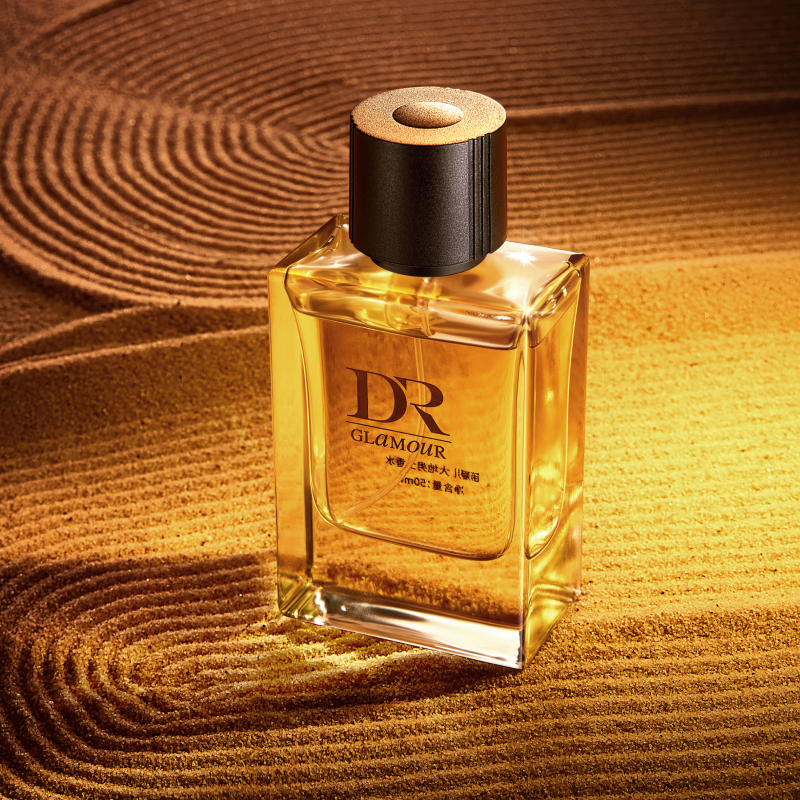
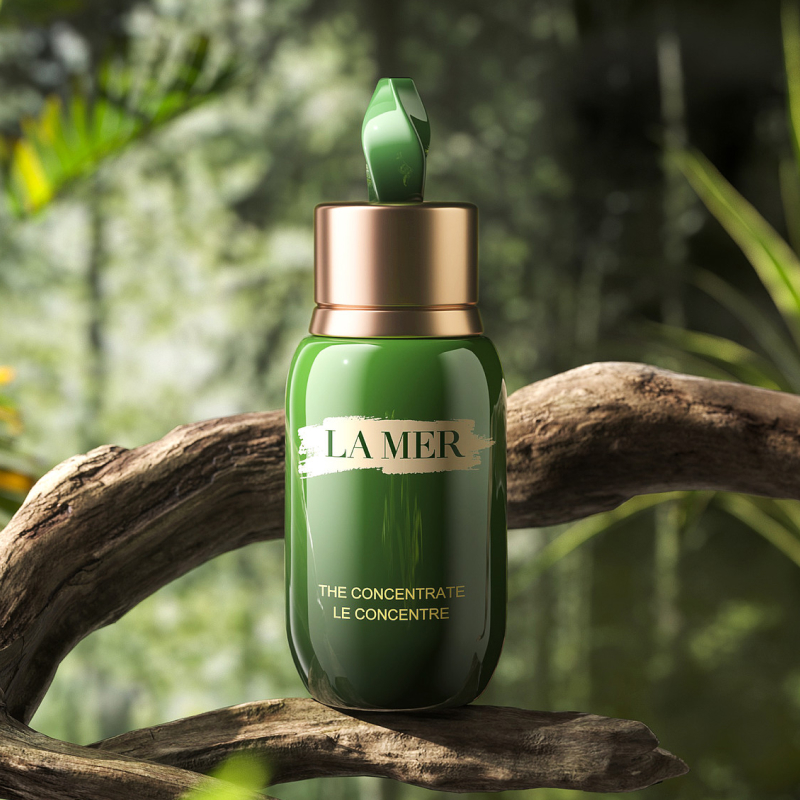
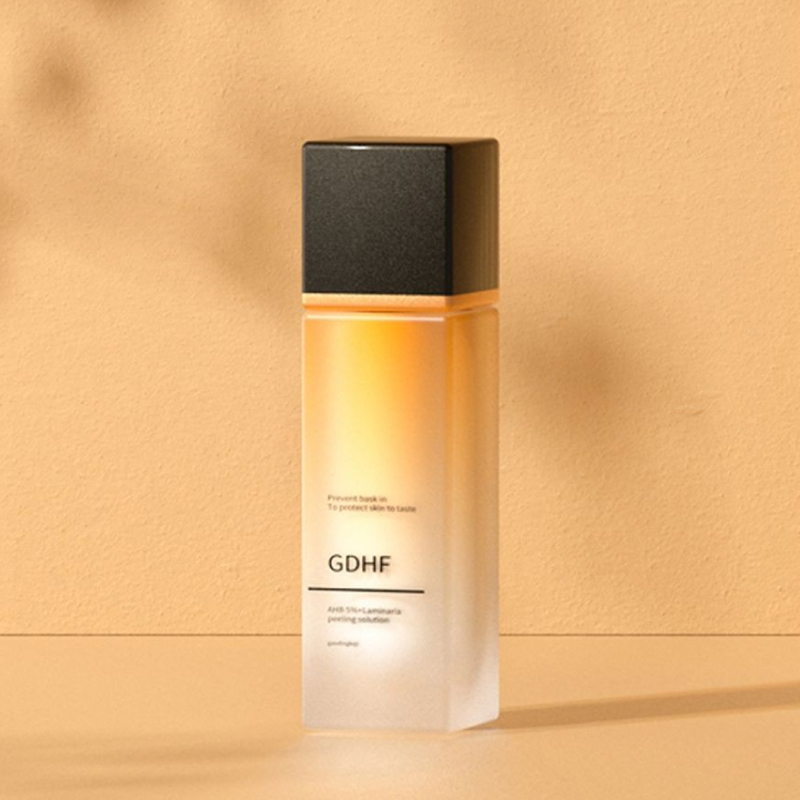
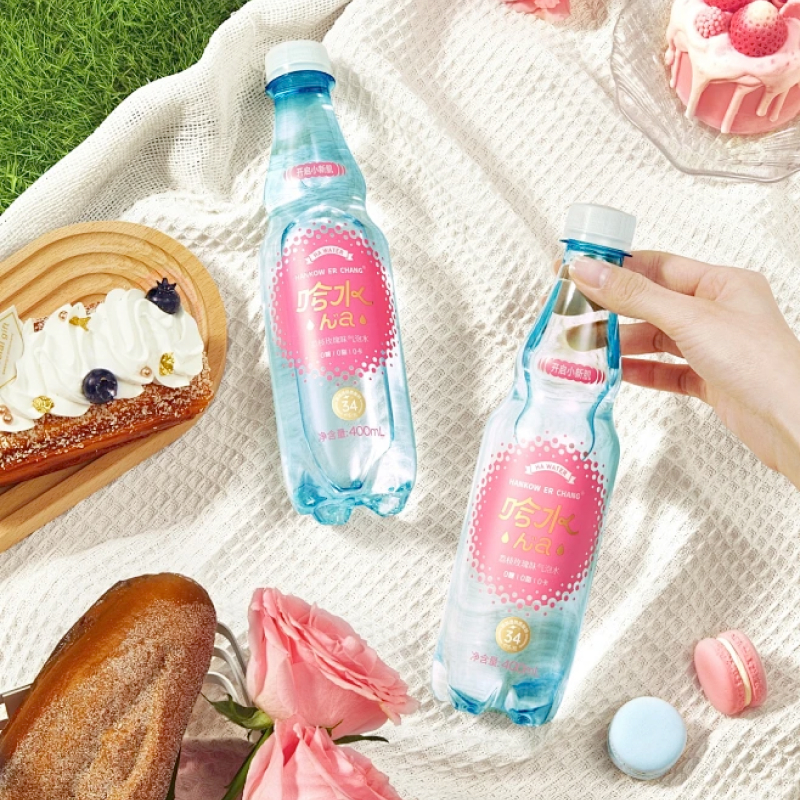
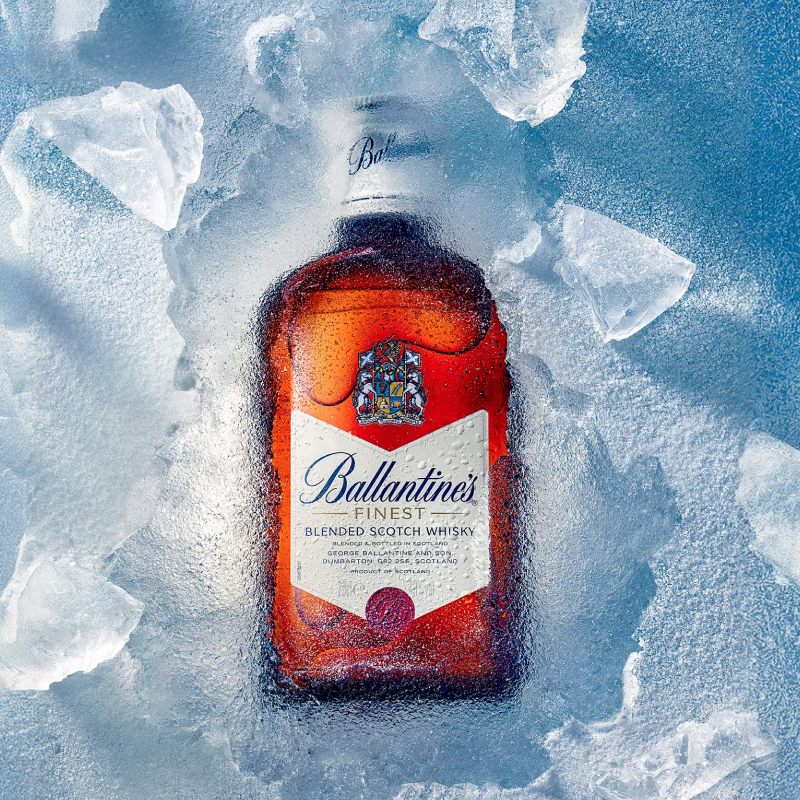
渲染
场景
户外
场景
地面
场景
桌面
场景
特殊
场景
loRa-1
LoRa-2
LoRa-3
LoRa-4
LoRa-5
LoRa模型训练
每个场景方向对应一个定向 LoRA,使模型能够按品类特征生成匹配的商业背景。从素材准备、标注、训练执行到测试验收全程负责,基于统一的验收标准迭代至达标。
按场景方向找图
针对每个场景方向,找到符合特征的图像素材,兼顾特殊品类的空间关系
素材清洗
对原始素材做筛选和处理,去除质量不达标、特征不明确、空间关系不准确的图像
结构化标注
将商品信息与场景特征标注为算法可读取的训练语料,确保设计判断可被模型训练消费
构成数据集
清洗+标注后的素材集即为训练数据集,每个场景方向 100+ 图像样本
ComfyUI -workflow编排
训练好的 LoRA 模型无法独立完成换背景——需通过 ComfyUI 工作流将模型调用、抠图处理、产品叠回与光影修饰演化为有序的可控链路。工作流的核心职责是替代人工逐步操作,实现从输入商品图到输出场景背景图的批量自动化生成。
06 / 图文布局规范与自动化生成
不只生成背景图,还要能直接投放
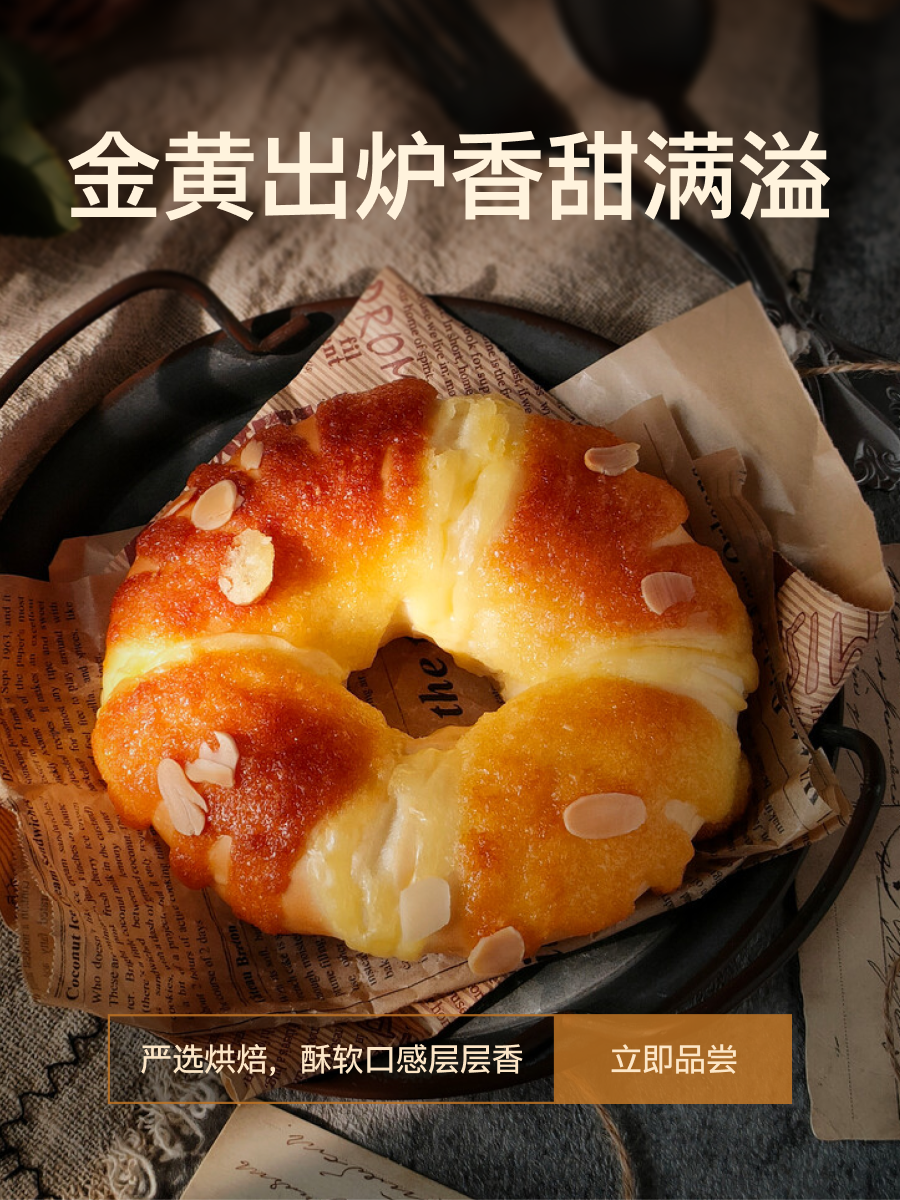
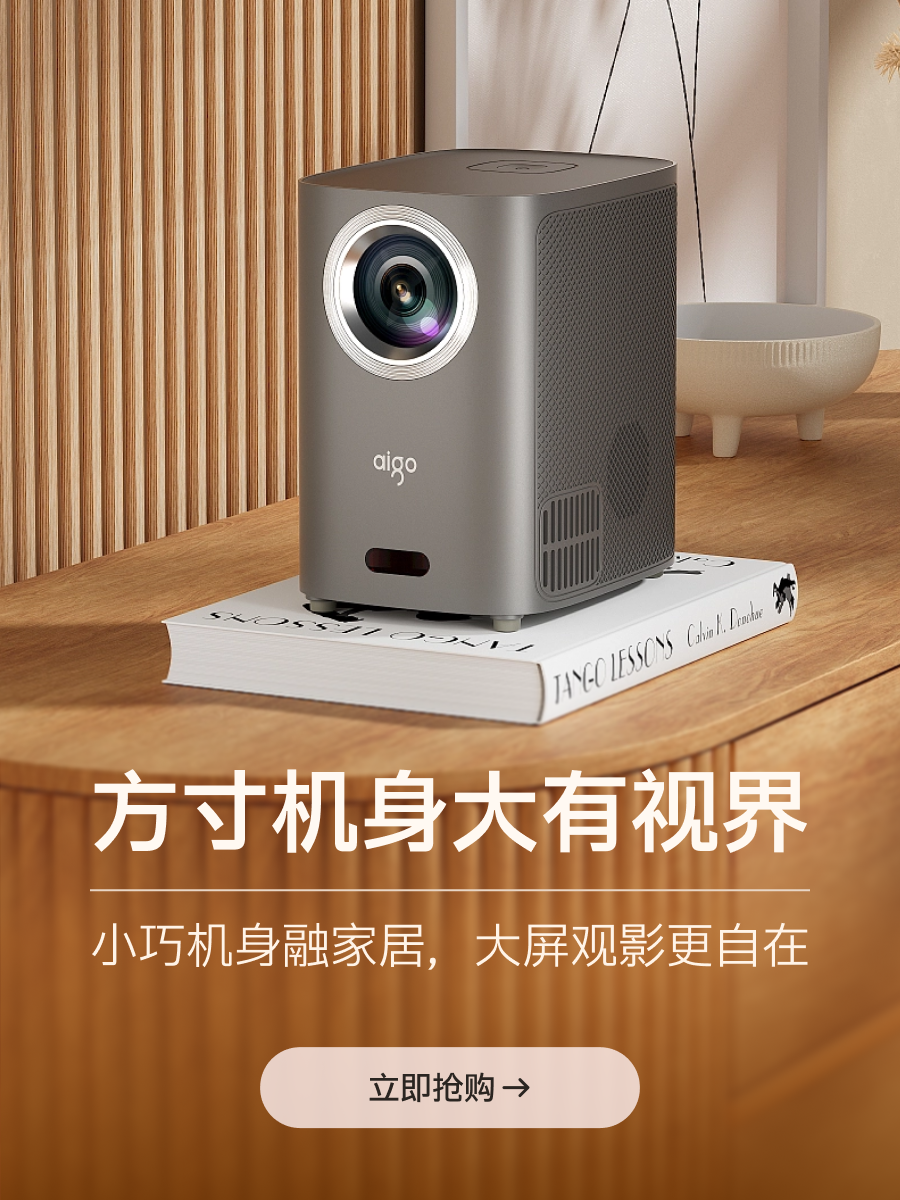
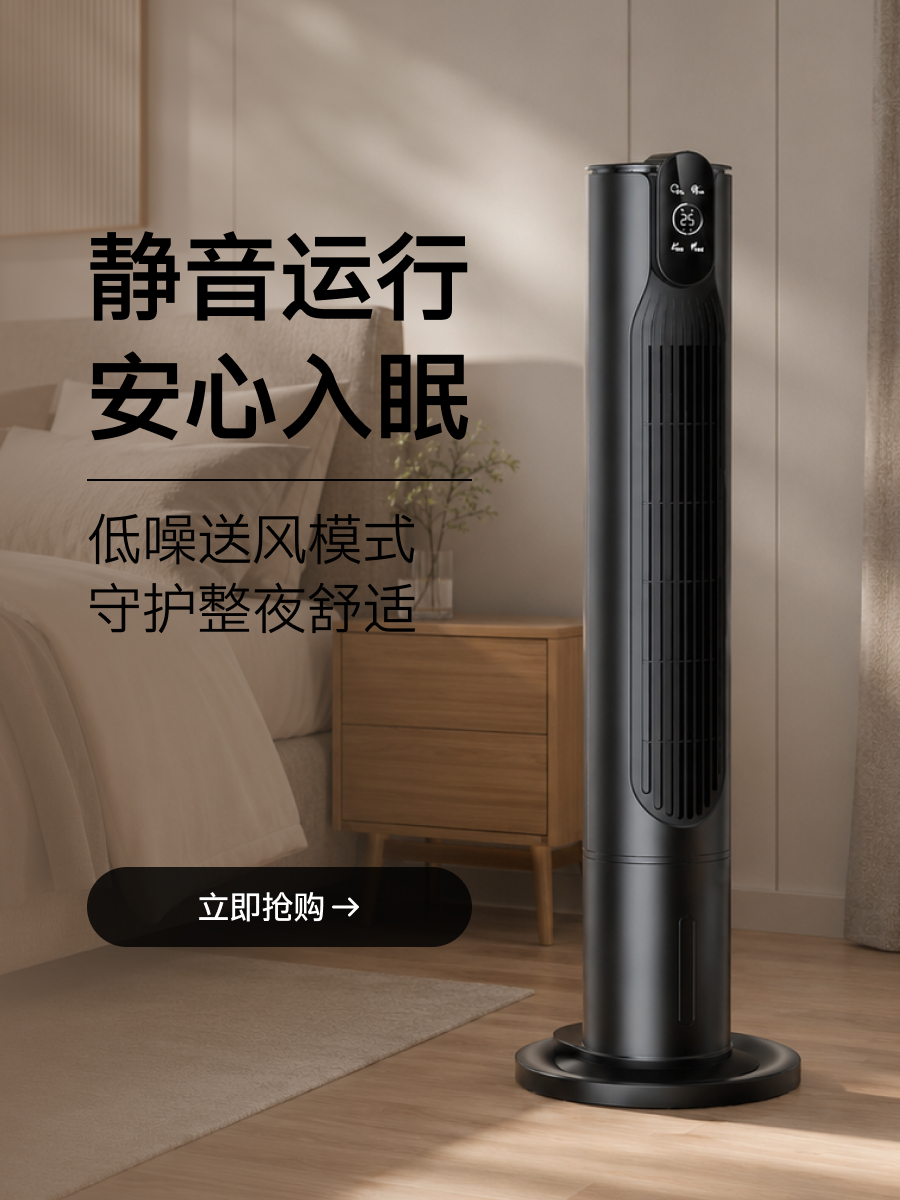
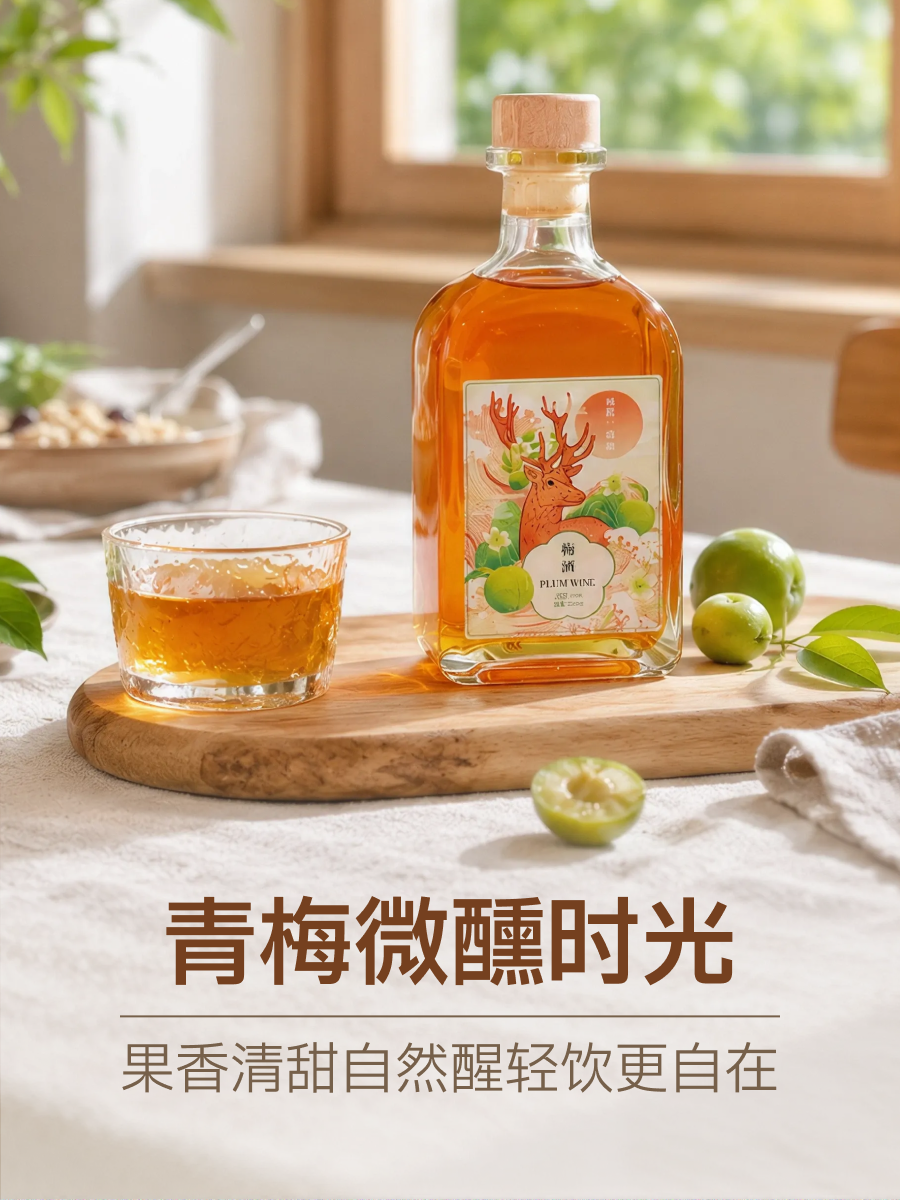
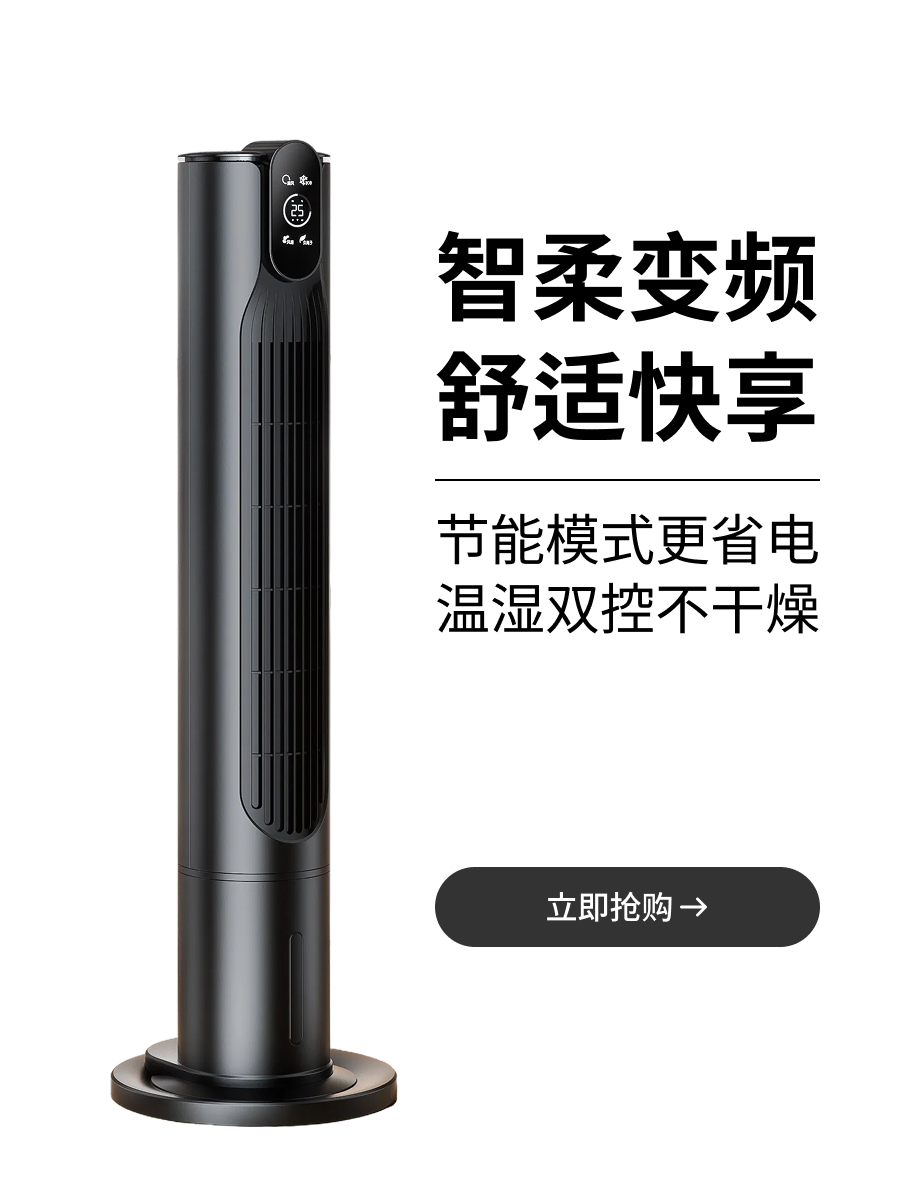
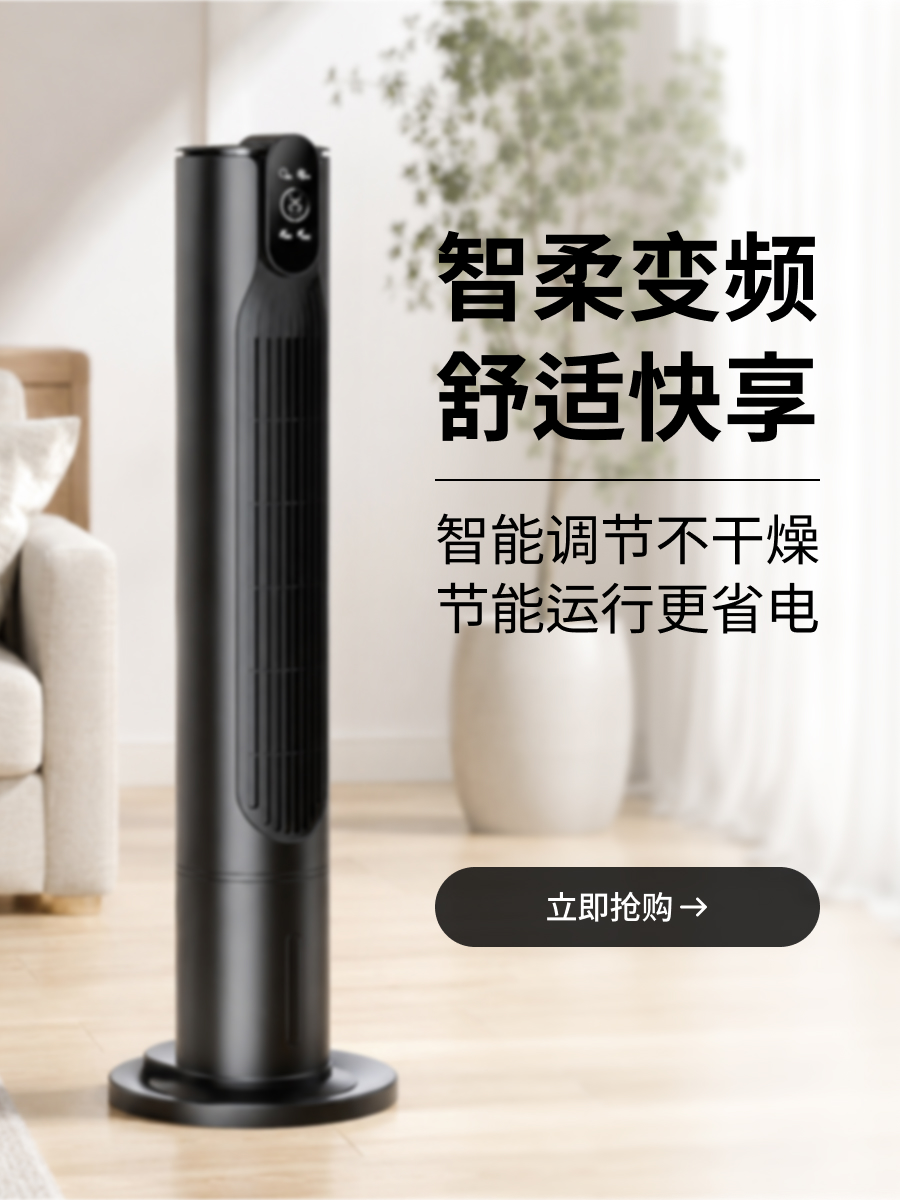
背景图生成为基础能力。要进入首焦图、入口图等真实投放场景,还需要制定图文布局规范——在商品图安全区域内计算图像区域与文本区域的配比,根据背景图色彩系统动态调整文案颜色,最终通过识别 SKU ID 携带的信息实现自动化布局生成。
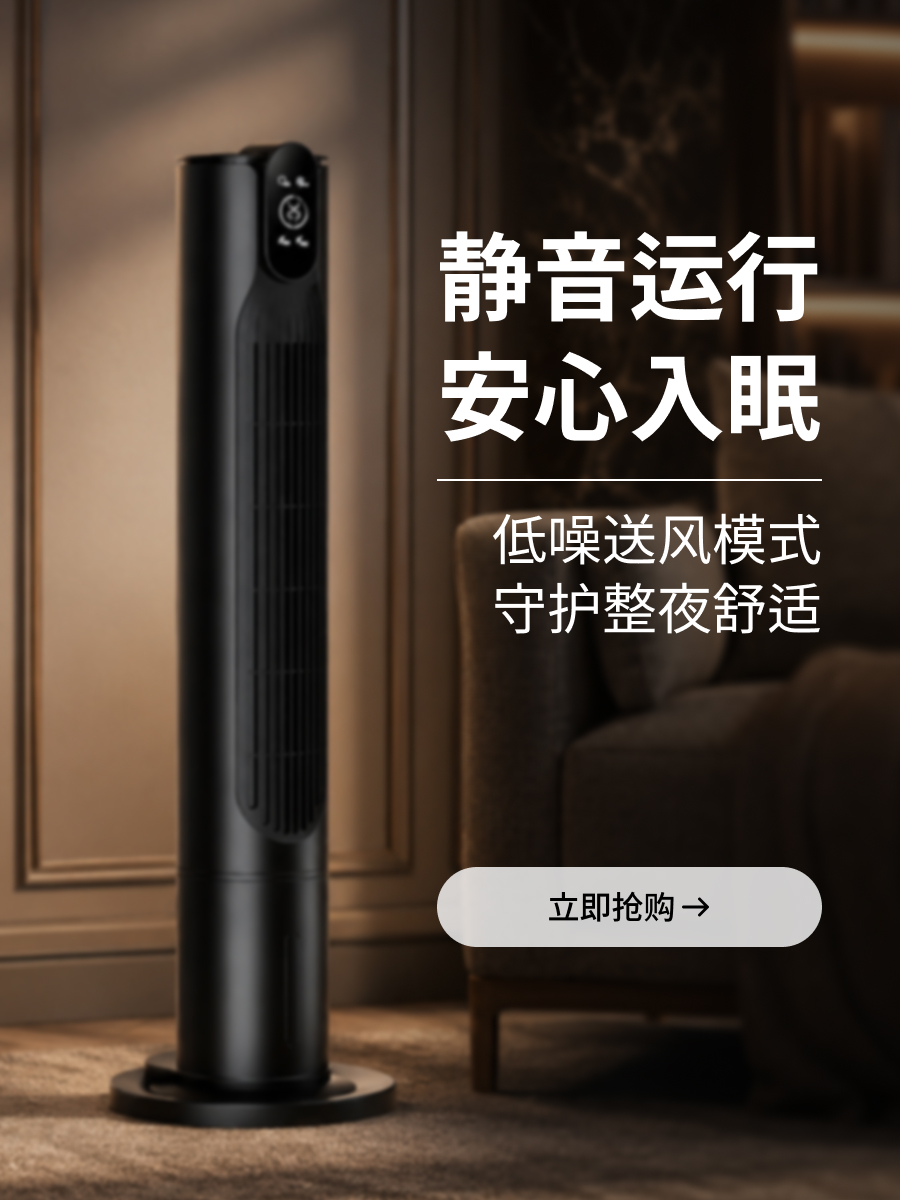
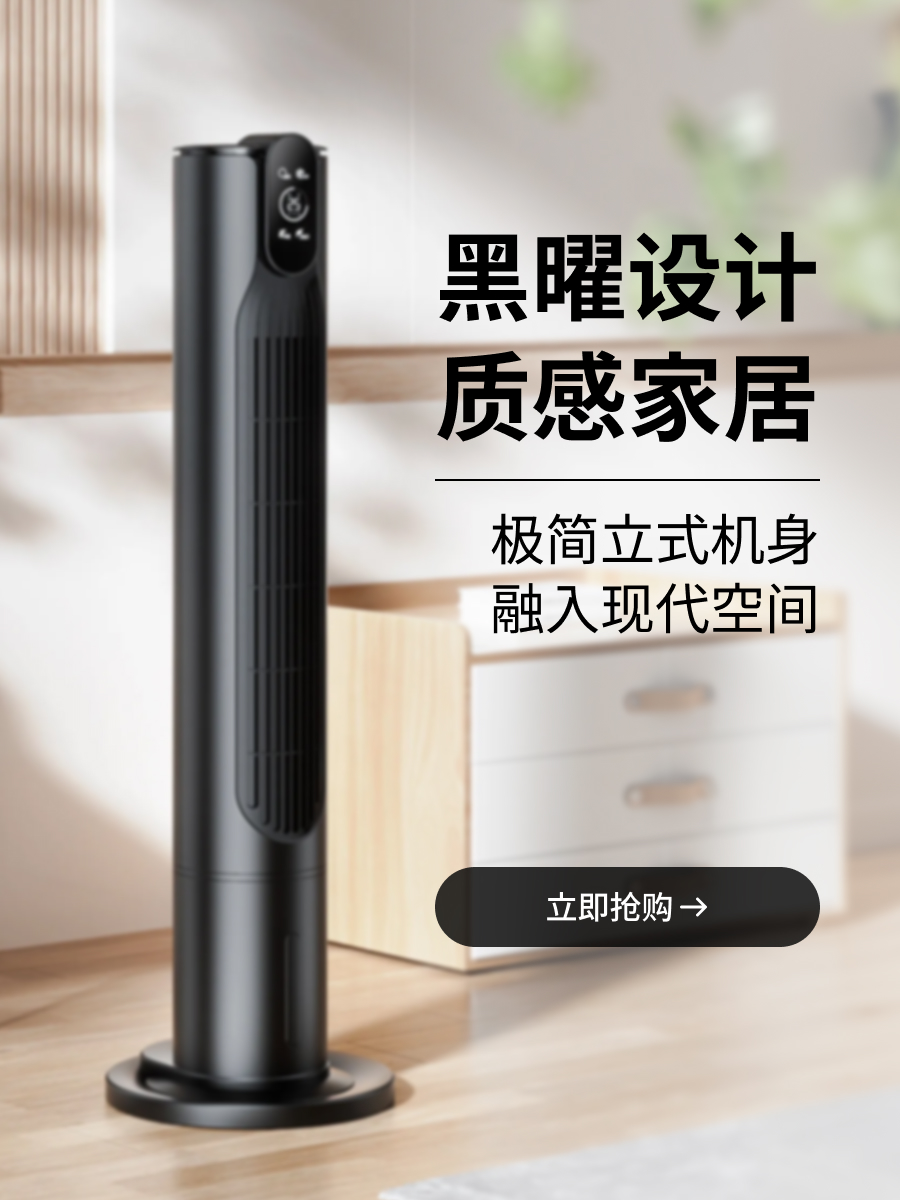
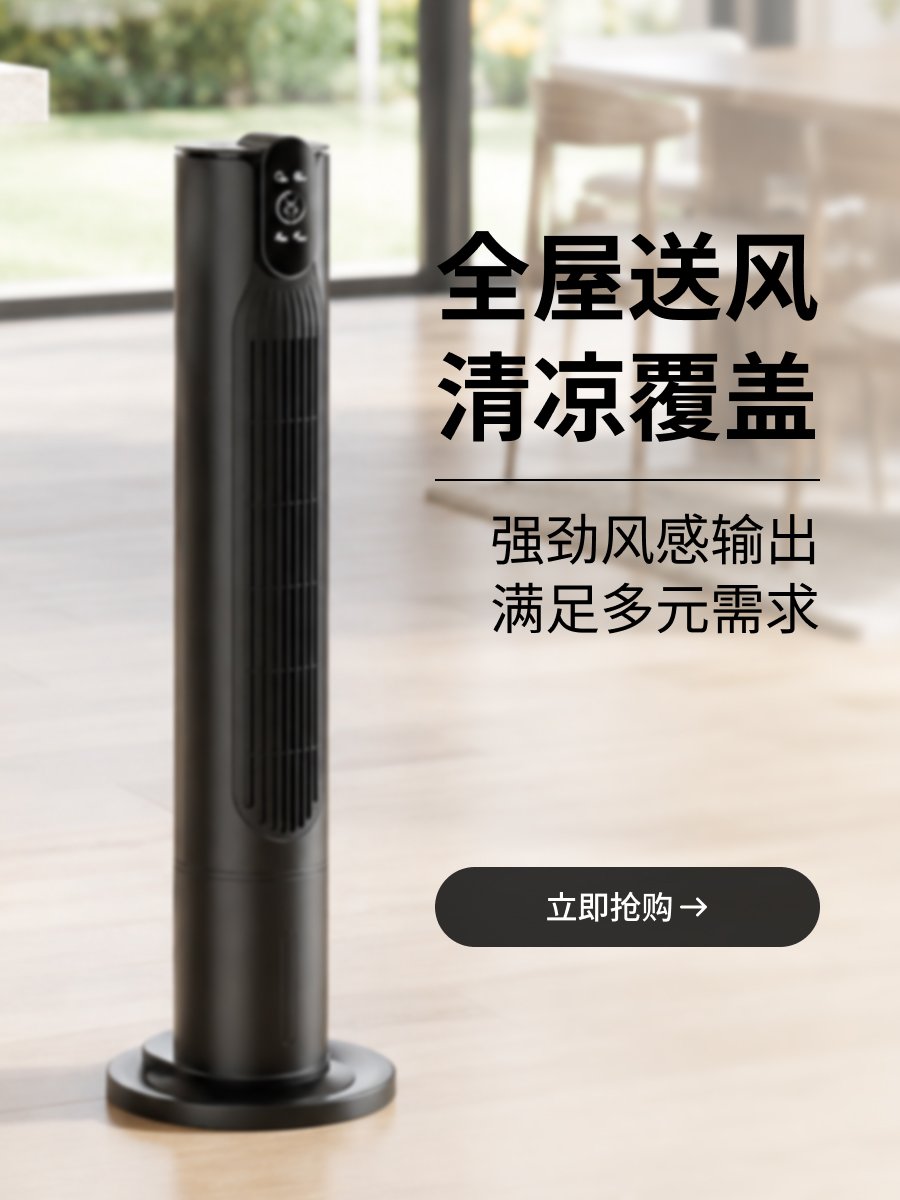
图文布局规范
在自动化生成背景图的基础上,通过识别 SKU ID 中携带的产品图、标题、价格、评论等信息,进行主标题、副标题、点击引导的自动化布局生成。核心原则:产品为画面主体,占比须充分展现产品特征;文案其次,不得遮挡商品。
动态自适应配色
优先黑白,确保可读性下限;
其次自适应,根据背景图色彩生成协调的彩色文案。色彩系统基于 WCAG 2.0 AA 级对比度标准构建——正文对比度 ≥ 4.5:1,大号文本对比度 ≥ 3:1。深背景配白字、亮背景配黑字为默认兜底,在此基础上按背景图与产品的色彩均值做色相偏移,得出与画面协调的彩色文案。